 物界前沿
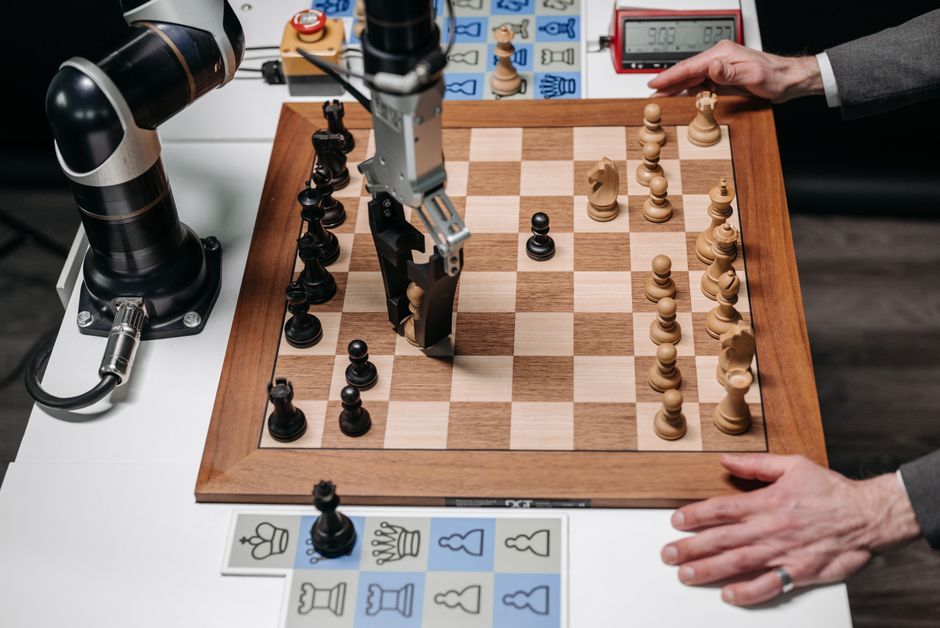
大模型下棋,先别问棋力

被朋友安利了 Chess5.ai,试试看到底好不好用。
结论先给,推荐当 LLM 行为观察器,不推荐当棋力测试器。LLM 就是大语言模型,行为观察器是看它怎么输出、怎么犯错。适合研究 agent、规则校验、多模型对比的人;agent 可以简单理解成程序让模型读状态、选动作、再回写。不适合真拿它评估棋艺。看情况。
我这两天在网页上点了几个模型。首页有 Chess、Go、Xiangqi、Gomoku、Othello,对手列了 GPT、Claude、Qwen、DeepSeek 等。我只拿 Qwen 和 DeepSeek 试了五子棋、象棋,又用围棋小盘摸了一下。
界面比我想得朴素。左侧棋盘,右侧选走法。模型只能在合法动作里挑,不能自由输出我下这里。非法走法会被拦,这反而让我觉得可用。
踩坑比想象明显。五子棋里,Qwen 开局会摆样子,但中盘容易只顾自己连线,不堵对面。它偶尔给出一个不在合法空位里的坐标,前端提示重新选。象棋更明显,DeepSeek 选马会忘蹩马腿,选炮会漏翻山。围棋小盘还能应付,盘面一宽就开始丢上下文。
我拿本地 llama.cpp 和 Qwen-7B 做了粗糙对照,把棋盘转成文本状态,让模型输出坐标,再用 Python 校验。裸模型并不适合自己维护棋盘,状态一长就忘上一手。Chess5.ai 的价值是把状态、动作空间、合法性检查、UI 包在一起。瓶颈更多是上下文表示和动作约束。
| 游戏 | 常见问题 | 适合看什么 |
|---|---|---|
| 五子棋 | 防守意识不稳 | 动作空间是否够小 |
| 象棋 | 马腿、炮翻山容易错 | 规则能否拦住幻觉 |
| 围棋 | 边界和劫争会漏 | 长上下文状态管理 |
| 黑白棋 | 翻转逻辑容易忘 | 状态更新是否显式 |
从工程看,它没做端到端下棋的大融合,更像外挂了一个运行时安全闸门。这想法和我之前写的本地智能体安全闸门差不多,模型可以提议动作,但系统必须能拒绝。棋类里这个算子融合还没做,也不急着做。把棋盘 IR 单独维护,IR 就是棋盘状态的中间表示,模型只输出候选动作,比让模型自己数子、记状态、判胜负稳。
缺点也明显。它不适合严肃评估棋力,模型版本、提示词、动作选择方式都会影响结果。对小白也不友好,容易被 LLM vs LLM 的噱头骗到,以为模型真的理解棋局。我这边测下来也有等待,尤其模型列表多,体验取决于后端 API,也就是模型服务接口。有人拿 13 个模型测过,结论很冷,它们更多是在动子,赢棋还谈不上。
优点也实在。它把多个游戏、多个模型、合法走法校验放到一个入口,省得自己搭测试外壳。对想研究 agent 的人,这比看跑分直观,能清楚看到模型什么时候幻觉、什么时候遵守约束、什么时候需要回退。
适合做 AI 工具链、agent 评测、本地推理、提示词工程的人试。下棋爱好者可以当乐子,别当真。不适合想系统练棋的人,也不适合做正式模型能力基准。
它最有用的地方是把大模型放进棋盘规则里,照出它到底缺哪层约束。
📌 本文编译自 Hacker News,原文 https://chess5.ai/en
版权归原作者所有,本文为基于公开报道的编译与独立分析。
