 物界前沿
当物流公司把AI Agent当作万能螺丝刀

上周我在实验室带研究生跑一个供应链优化的仿真项目,把数据丢进几个公开的Agent框架里试了一轮,结果让我想起一个老问题:当一家物流公司决定引入AI Agent时,它真正买到的到底是什么?
短期看,这个问题很容易回答,—买的是效率,是自动化,是24小时不睡觉的调度员。我看到的几个案例里,AI Agent确实能处理一些重复性极高的任务,比如根据客户对话自动调整订单优先级,或者在多个承运商之间比价选优。Salesforce那个博客里提到,有企业用Agent做退货授权,实现了35%的自主解决率,这个数字在我看来是合理的,因为退货流程有明确的规则边界,属于结构化程度较高的场景。
但长线观察下去,答案就变得复杂了。我注意到,几乎所有关于AI Agent在物流中失败的案例,都指向同一个问题:数据基础设施的缺失。有个行业调查说,56%的首席供应链官认为,整合现代AI与他们的碎片化、模拟时代的遗留系统是最大的障碍。这组数据和我自己的经验高度吻合。我带过一个学生做物流知识图谱的项目,数据清洗花了整整三个月,因为不同运输商的数据格式、字段定义、时间粒度全都不一样,甚至连“交货日期”这个概念,有的用UTC,有的用当地时间,有的干脆只写“尽快”。
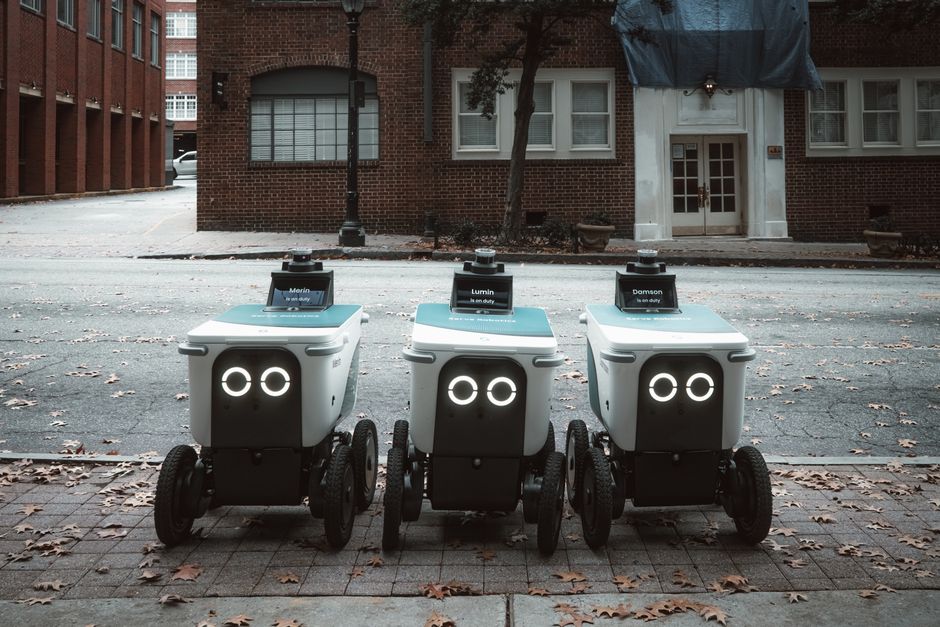
这张图是三个扫地机器人停在人行道上,我猜发帖人是想表达一个隐喻:AI Agent在物流领域的现状,就像这些机器人一样,看起来能跑能避障,但一旦遇到人行道上的台阶、路沿、突然打开的垃圾桶盖,就原地打转。物流的真实世界比人行道复杂得多,—海关规则、包装要求、危险品分类、最后一公里的临时改址,这些是扫地机器人永远学不会的“常识”。
我最近在教一门课,讲知识图谱在供应链中的应用。课上我反复强调一个观点:模型应平衡检索增强与参数记忆,知识选择是关键。在物流场景里,这句话尤其重要。一个AI Agent如果不具备从外部知识库中检索并验证信息的能力,它给出的路线优化建议就永远是“理论上最优”的。比如,它可能推荐一条时间最短的跨省运输路线,但忽略了那条路线上有一个临时安全检查站,导致货车排队四小时。这种问题,单靠训练数据里的参数记忆是解决不了的,必须依赖实时的、结构化的外部知识。
另一个让我注意的陷阱是“幻觉”。Accelirate那篇文章里提到,Agent会产生虚构信息,因为在某些问题上LLM缺乏足够的知识。在物流场景里,这种幻觉的后果不是闹笑话,是实实在在的损失。假设一个Agent在调度时说“可以选择A承运商,运费是XX元,时效是Y天”,但实际报价已经涨了20%,或者那个承运商根本不覆盖那条路线,结果就是客户投诉、货物延误、合同违约。我倾向于认为,这不是Agent的错,而是产品设计者高估了模型的确定性。Agent本质上是一个概率生成器,它不应该被当作一个确定性的数据库来用。
Medium上那篇文章说得挺到位:AI Agent很少因为不智能而失败,它们失败是因为我们误解了它们是什么。它们不是魔法决策器,也不是确定性软件。这句话点到了方法论层面的核心问题。在学术圈,我们管这叫“对任务的形式化理解不足”。你把一个需要因果推理的任务交给一个统计模型,它当然会出错。
所以短期看,物流公司应该优先投资数据基础设施,而不是直接买Agent。先把数据清洗、格式统一、实时接口搭建好,再谈自动化。否则Agent就是一套没有地基的房子。长期看,我预测AI Agent在物流领域的真正价值,不会体现在“取代人类调度员”上,而是体现在“增强人类决策”上,—比如,Agent可以自动生成多个候选方案,做初步的合规检查,把异常标记出来,把最终决策权留给人类。这个方向,更像是人机协作的增强智能,而不是替代智能。
毕竟,物流行业的核心竞争力从来不是算得快,而是在不确定性中做对决策。这一点,机器暂时还学不会,也可能永远学不会。
 本文编译自 Hacker News,原文:AI Agents for Logistics, Pitfall? | Hacker News
版权归原作者所有,本文为基于公开报道的编译与独立分析。


