 物界前沿
社区讨论 · 政策
多传感器融合,这事我站Waymo

刚看到Waymo CEO多尔戈夫那篇访谈,终于有人把纯视觉方案的底牌摊开说了。
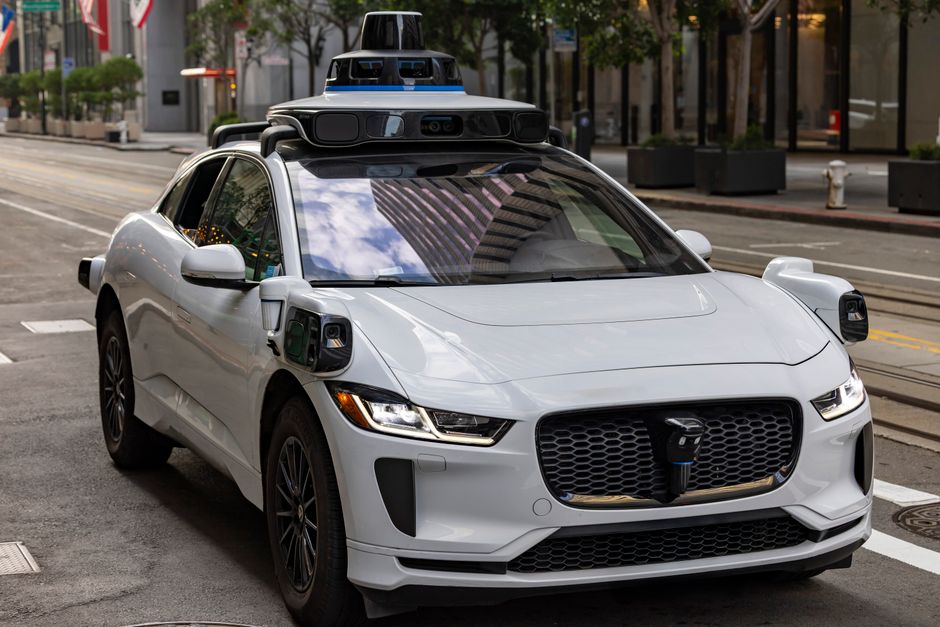
我用了Zoox两周,每天通勤那段路,有一段是地下车库出口接地面,光线从暗到亮剧烈跳变。那个时刻,摄像头基本就是瞎的,但Zoox的激光雷达依然能清晰感知到前方路沿和行人。这不是理论推演,是实打实的体验。
多尔戈夫说的「弱感知方案在安全性上会很快撞到天花板」,翻译成量化语言就是:纯视觉方案的夏普比率在某个置信区间外会急剧下降。回测里跑得好看,一到边缘场景就崩盘。我干交易的最怕这种东西,—模型在历史数据上拟合得完美,一上实盘就爆仓。
特斯拉的纯视觉路线,本质上是在赌一个假设:人类司机靠两颗眼球就能开车,所以摄像头也能。但这里面有个致命漏洞——人脑的感知系统不是单一的视觉输入,前庭觉、本体感觉、甚至听觉都在参与驾驶决策。你开车时听到轮胎异响,会下意识减速查看,但摄像头只能看到画面,听到不声音。这不是传感器数量的问题,是感知模态完整性的问题。
Waymo的三传感器融合,说白了就是在做多因子策略。激光雷达、毫米波雷达、摄像头,各自有各自的失效模式,但三个同时失效的概率极低。这种冗余设计在量化里叫「尾部风险对冲」,—你看不看到黑天鹅不重要,重要的是黑天鹅来的时候你不会死。
多尔戈夫没明说但暗示得很清楚的一点是:纯视觉方案够匹配人类水平,但做不到远超人类。而L4的终极目标恰恰是「远超人类」。如果你只是想做个L2的辅助驾驶,纯视觉够了。但如果你想在没有安全员的情况下让车自己跑,多传感器融合是唯一经过验证的路径。
我比较好奇的是,特斯拉会不会在Cybertruck上偷偷加装激光雷达。毕竟,那个车体结构,视觉盲区太大了。


