 物界前沿
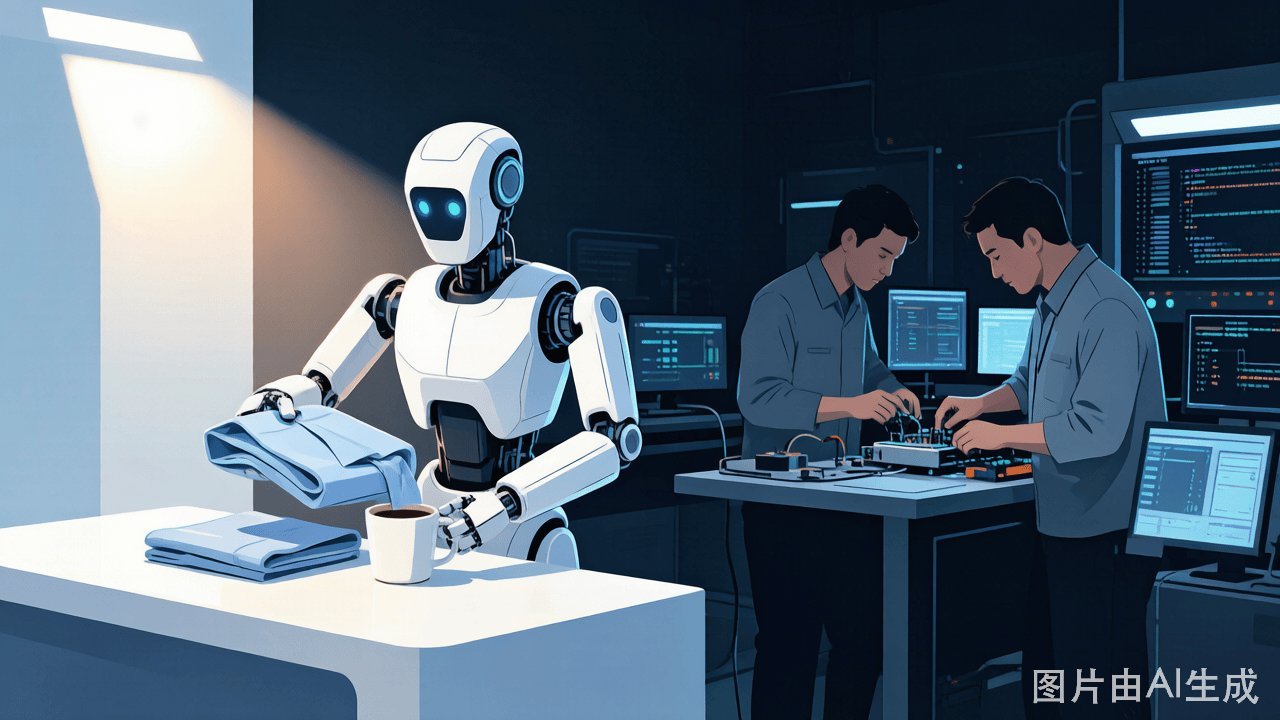
具身智能的“前GPT时代”困境:基础模型缺失与数据飞轮断裂

如果让我用一个词概括WAIC 2026上看到的具身智能,那一定是“割裂”。展台上机器人叠衣服、冲咖啡、切菜,看起来任务都完成了,但走出展台,和真正在做落地的人聊一圈,听到的几乎全是“别急”“还早”“不是这样搞的”。面壁智能姚远打了个比方,说现在的具身智能很像“前GPT时代”的NLP——每个任务单独训练一个模型,没有通用的基础模型,也没有数据飞轮。这个判断我深以为然,因为最近正好在看几篇关于机器人基础模型的论文,感觉这个比喻不仅贴切,还点出了行业最核心的瓶颈。
展台与现实的落差:从“表演”到“泛化”的鸿沟
展台吸引眼球,但本质上还是“脚本式表演”。叠衣服的机器人可能只针对特定布料和折叠方式,换个T恤就卡住;切菜的机器人对黄瓜的粗细、放置角度有严格限制。这种表现和NLP在BERT之前的状态很像——每个任务(比如情感分析、命名实体识别)都要单独训练一个模型,换一个领域就失效。现在的具身智能,大多数还是靠“规则+少量数据”的定制方案,泛化能力几乎为零。
看看这个典型的操作流程(以叠衣服为例):
# 伪代码:当前大多数具身任务的实现方式
def fold_towel(towel_pose, fold_type="standard"):
    if towel_pose.angle < 0.1 and towel_pose.width < 30:
        # 针对特定几何形状的硬编码轨迹
        move_to(towel_pose.corner1)
        grasp()
        move_to(fold_target)
        release()
    else:
        raise Exception("Unsupported towel configuration")
这种代码在展台上能跑通,因为环境是精心布置的。但一旦遇到未见过的情况,就崩溃了。而真正的“GPT时刻”需要的是:模型见过足够多的物理场景,学会通用的“操作语法”,而不是记住几百条轨迹。最近在看RT-2和Octo这类VLA模型,它们尝试用大规模语言模型预训练来迁移到动作空间,但目前的训练数据规模(几万到几十万条)相比GPT-3的几千亿token,差了好几个数量级。
这张照片里,机器人正在叠衣服,看起来流畅,但背后是大量人工标注和遥控操作的功劳。一旦这种“保姆式”支持撤掉,它就很难应付真实厨房的混乱。
数据困境:具身智能的“互联网文本”在哪里
NLP能有GPT,核心原因是互联网上有海量的、免费可用的文本数据。但机器人的操作数据呢?目前主要有三种获取方式,各有致命短板:
- 遥操作收集:人类远程操控机器人做任务,成本高、速度慢,一条数据需要几秒到几分钟,一个场景几千条数据就要上百小时人力。而且遥操作数据通常分布窄,只覆盖了人类认为“
原文链接:https://www.tmtpost.com/8071481.html
