 物界前沿
叠盒封胶90%成功率:具身智能从“看见”到“做到”的跨越

这篇文章最有价值的信息是魔法原子在Magic-VLA K02上实现了叠盒封胶这类长程任务90%以上的成功率——这不仅是数字上的进步,更暗示了具身智能模型在“任务分解”和“闭环控制”两个关键维度上可能已经迈过了实用门槛。
作为刚进实验室的研一学生,我最近正好在补具身智能的论文。从RT-1到RT-2,再到现在的VLA(视觉-语言-动作)范式,我们一直讨论“如何让机器人学会长序列操作”。但看完这篇新闻,我意识到一个更现实的问题:实验室里的高成功率,和真实场景中的鲁棒性,中间还隔着什么?
叠盒封胶到底难在哪里?
先拆解一下这个任务本身。叠盒封胶看起来简单,实际包含多个子步骤:抓取扁平的纸盒、折叠成型、对齐边缘、涂胶、按压固化。每一步都需要精确的视觉反馈和力控调节。如果哪一步精度偏差超过1-2毫米,后续步骤就会失败。
传统方法通常依赖手工设计的视觉关键点检测和轨迹规划,但泛化到不同规格的纸盒、不同光照条件时,成功率会断崖式下降。Magic-VLA K02采用端到端的VLA模型,直接输入图像输出动作序列,绕过了繁琐的中间表达——这是它最大的技术亮点。
我在看论文时注意到,VLA模型的核心挑战是“动作空间”的表示。如果动作粒度太粗,无法完成精细操作;太细,搜索空间爆炸。Magic-VLA K02会不会用了某种层级化的动作基元?比如将“折叠”定义为一个高层动作,内部再调用底层控制?这可能是后续技术细节值得关注的地方。
90%成功率意味着什么
从研究角度看,90%是一个微妙的分界线。 如果只有70%,说明模型可能记住了特定场景下的模式,泛化有限;如果达到95%以上,几乎可以部署到产线。90%恰好处于“有实用潜力但还需要优化”的区间。
更让我感兴趣的是,他们展示的不仅是叠盒封胶,还有柔性衣物整理和行李箱收纳。这三个任务覆盖了刚性物体、柔性物体、杂乱场景三种典型类型。如果同一个模型架构能同时处理这三类任务,那就说明Magic-VLA K02不是特化模型,而是朝着通用具身大脑迈出了实质性一步。
不过,我也有疑问:这些任务是在固定场景下演示的吗?环境变化(比如光照、背景、桌面材质)会不会导致成功率骤降?新闻里没有提泛化测试的数据,这是未来值得深挖的方向。
从研究视角看技术路线
对比一下当前的VLA主流方案:Google的RT-2采用互联网预训练+机器人微调,强调“世界知识”的迁移;而国内不少团队更关注动作闭环的实时性,比如通过轻量级视觉编码器减少推理延迟。Magic-VLA K02的命名暗示它可能是一个迭代版本,K02或许是第二代芯片或模型架构。
我猜测他们的技术路线可能有以下几个特点:
- 视觉-语言-动作联合训练:不仅学习做动作,还学习理解语言指令和场景语义
- 长程任务分解:可能利用了大语言模型的推理能力,将“叠盒封胶”拆成子任务序列
- 在线学习或强化学习:90%成功率可能来自仿真环境的大量训练,再迁移到真实世界
对于刚入门的研究者来说,这个案例值得反复咀嚼。它告诉我们,具身智能的瓶颈已经从“能否做”转向了“能否可靠地做”。而“可靠”背后,是对数据质量、模型鲁棒性、硬件一致性的系统工程要求。
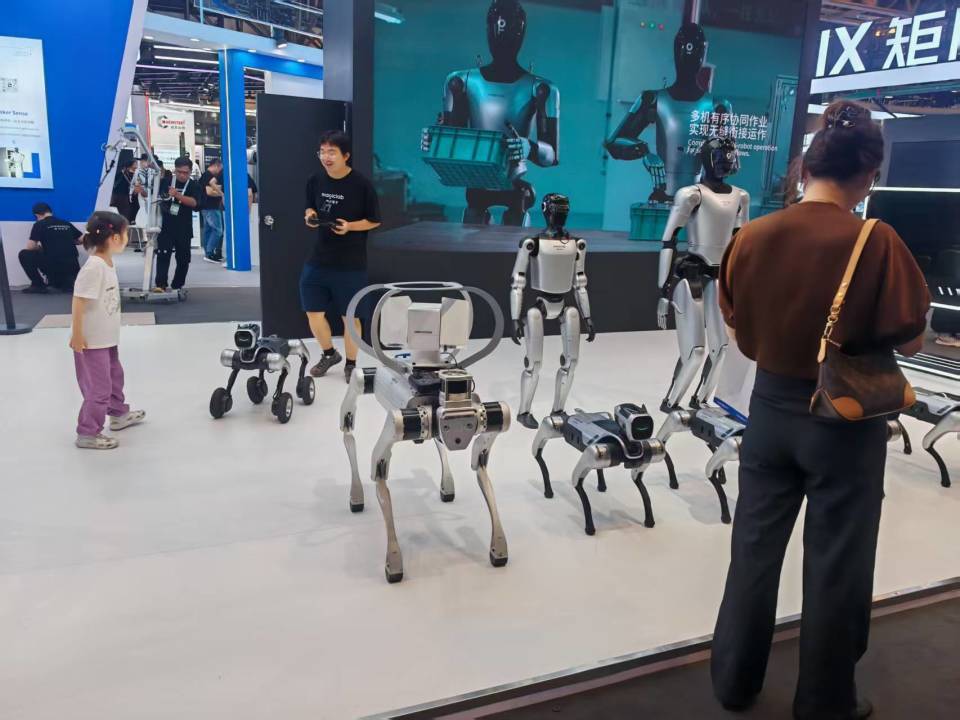
[!note] 这张图应该是WAIC现场的演示画面,可以看到机器人正在执行叠盒操作。如果仔细观察机械臂的末端姿态,或许能推测出他们使用的夹具设计——这是影响抓取成功率的关键硬件细节。
一些值得跟进的研究方向
作为实验室新人,我打算从以下几个方面追踪这个工作的后续进展:
1. 数据收集策略:他们用了多少叠盒封胶的演示数据?是否包含失败样本?数据多样性如何?
2. 动作频率与延迟:VLA模型的推理延迟是多少?对于需要实时力反馈的涂胶操作,是否足够快?
3. 迁移到其他任务:仓库中常见的开箱、抓取、码垛等任务,能否用同一套权重直接执行?
Magiv-VLA K02的成功,本质上是将“感知-规划-控制”三者融合进一个端到端模型的工程胜利。 但真正的突破,可能在于它证明了“长程任务的低错误率”不再需要显式编程,而是可以通过数据驱动的方式实现。对于刚起步的研究者,这个信号比任何技术细节都更重要——它告诉我们,具身智能的下一阶段,核心竞赛将从“算法创新”转向“数据工程的系统化”。
原文链接:https://www.qbitai.com/2026/07/454155.html