 物界前沿
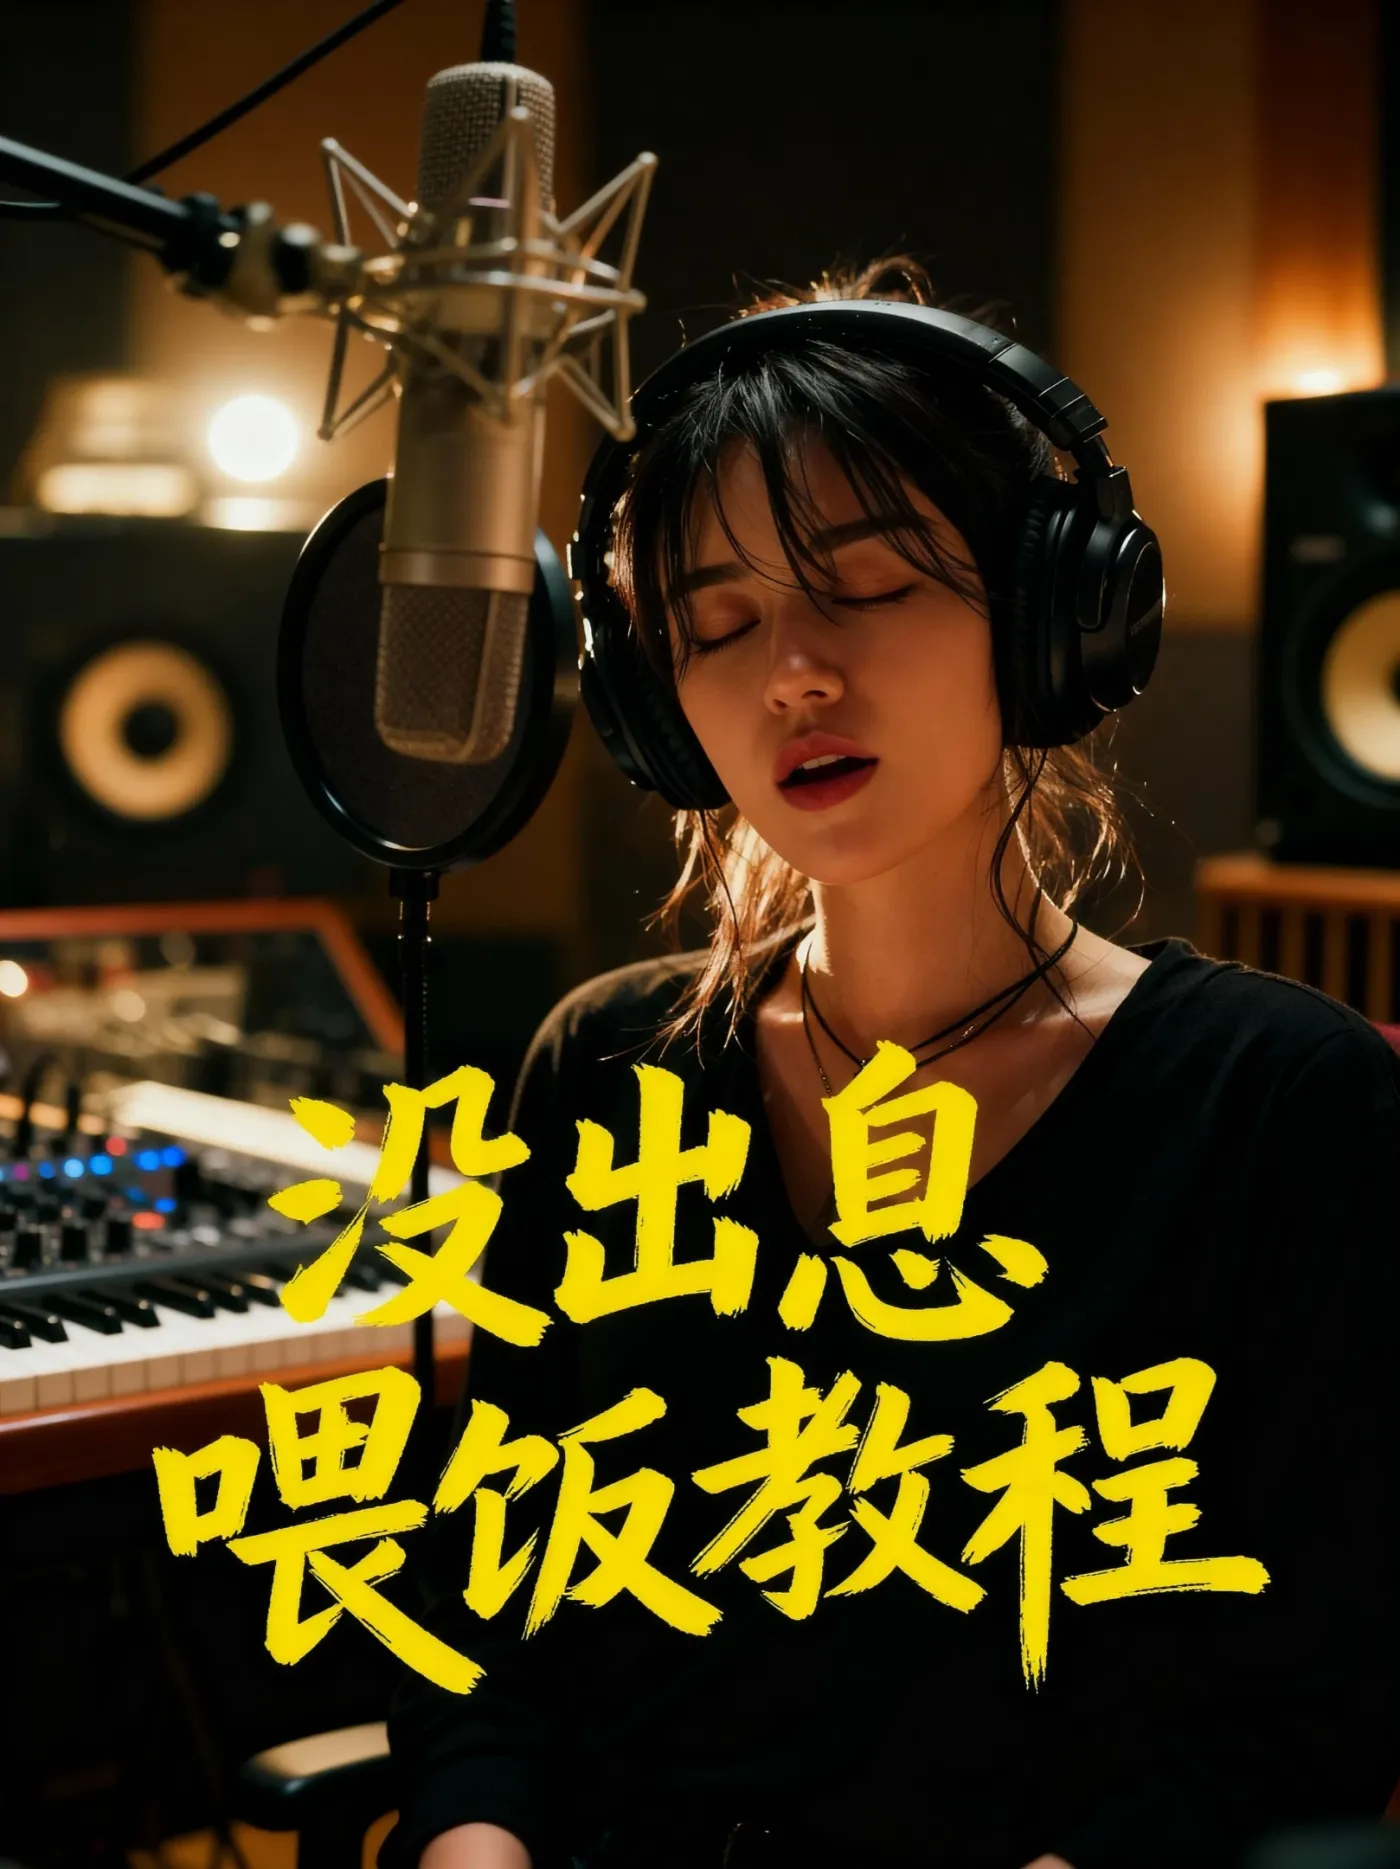
《没出息》喂饭教程来啦 看看谁有出息一学就会?#没出息 #ai教程 #ai创作浪潮计划 #2025AI年终大赏 #ai新星计划
AI 歌手 MV 怎么做:从一张角色图到对口型成片
Midjourney × 即梦数字人 × 剪映|视频拆解、可复刻步骤与实测评估

图 1|原视频展示的最终效果:统一角色、录音棚光影、近景演唱与对口型。
先说结论:这套方法能不能复刻?
能。照下面的流程,可以稳定复刻出“同一位 AI 歌手在录音棚中、多机位演唱、口型跟随歌曲”的整体效果。复刻的是制作逻辑、画面质感和镜头结构,不是每次都生成一张完全相同的脸。
流程复刻难度:中等。 工具都是可视化操作,真正耗时的是挑图和返工。
角色一致性:中上。 所有分镜都从同一张主角色图继续生成,一致性会明显高于每个镜头从零抽卡。
口型成功率:中上。 正脸或三分之二侧脸、嘴部无遮挡、单人干净人声、每段 4—8 秒时最稳。
动作稳定性:中等。 “唱歌+手势+环绕镜头”一次写太多,容易出现手指变形、脸漂移或卡顿。
结论:适合复刻。 先做 20—30 秒样片,通过后再扩成长视频;不要一上来生成整首歌。
原视频的真实链路是:先用 Midjourney 生成角色图,再用即梦生成同角色分镜;剪映把歌曲按完整歌词句切成短 WAV;即梦“数字人”逐镜头生成对口型视频;最后回到剪映,用一条完整歌曲音轨统一成片。聊天截图中博主还提到“即梦、万象都可以跑,早期用过 Wan2.5”,所以本文以视频里实际展示的即梦流程为主,万象作为备选。
第 1 步|准备素材,并先定下可验收标准
准备三样东西:一首有使用权的歌曲、一个 16:9 横屏项目、一个用于整支 MV 的角色设定。建议先选 20—30 秒副歌做样片。
开始前把验收标准写清楚:角色发型、耳机、服装和主光方向不能跳;嘴唇必须完整可见;每个镜头只安排一个主要动作;最终音画误差以“爆破音和闭口音是否对上”为判断,不以波形完全重合为唯一标准。
版权提醒:仅使用自己拥有或已获授权的歌曲、人物肖像、声音和素材。本文对原视频做方法拆解,不代表获得原视频或其中音乐的转载授权。
第 2 步|用 Midjourney 生成主角色图
进入 Midjourney 的 Create 页面,把下面提示词粘贴到输入框。原视频使用的是 Version 7、Standard、16:9,并一次生成 4 张。Midjourney 当前默认模型可能已更新;为了更接近原视频质感,请手动选 V7,或在提示词末尾保留 --v 7。
close-up of a beautiful young female singer singing with deep emotion in a professional recording studio, wearing headphones and standing in front of a large microphone, soft warm lighting, studio background with blurred sound equipment, her eyes slightly closed as she sings with passion, cinematic angle, cozy color tones, emotional atmosphere, realistic style, ultra detailed, high resolution --ar 16:9 --v 7

图 2|原视频中的主角色提示词。本文把国籍描述改成“年轻女歌手”,不影响录音棚构图。
参数这样设:比例选 16:9;模型选 Version 7;模式先用 Standard;一次生成 4 张;速度 Relax 或 Fast 都可以。只有当画面过度美化、不听提示词时,再切 Raw,不必一开始就开。

图 3|参数区可见 Version 7、Standard、速度和生成数量。复刻重点是 V7、16:9、4 张。
四张图里只选一张作为“母图”。合格母图必须同时满足:脸清楚、五官不崩、嘴唇没有被麦克风或头发遮住、两只耳机结构正常、手尽量不入镜、背景有纵深、主光方向明确。任何一项不过关,就继续抽卡,不要带着缺陷进入视频环节。
第 3 步|用同一母图生成 3—5 张分镜图
把选中的母图上传到即梦图片生成,并作为图片参考。不要重新描述一位新人物,而是要求“移动机位、保持角色和光线”。先做 3 张就够:正面近景、三分之二侧面、带前景麦克风的近景。
正面镜头提示词:
将镜头机位移动到人物正前方,保持同一人物、同一发型、同一黑色服装和耳机;吊式麦克风在人物前景轻微虚化,但不要遮挡嘴唇;角色闭眼深情演唱;延续原图暖色逆光和录音棚氛围,16:9。
三分之二侧面提示词:
保持同一人物、服装、耳机和暖色逆光,将机位移动到人物左前方约 30 度;人物演唱,嘴部完整可见;录音棚设备虚化,画面写实、电影感,16:9。

图 4|视频里的核心写法:不是“再生一张人像”,而是让机位移动,同时限定前景、表情、背景和光源。

图 5|选图时优先看嘴部、耳机和光线是否连续;轻微构图差异反而有助于形成多机位。
如果脸变了:提高参考图权重,删掉“换造型、换服装、换场景”等描述;如果麦克风挡嘴:明确写“麦克风前景虚化,不遮挡嘴唇”;如果侧脸口型容易失败:把角度从 60—90 度退回 20—35 度。
第 4 步|在剪映里把歌曲按完整歌词句切成 WAV
新建剪映项目,导入歌曲。把播放头放在一句歌词结束后的自然停顿处,执行“分割”。每段建议 4—8 秒,原视频示例约 6 秒;不要在一个字的中间切开,也不要让一段包含两次很长的换气。

图 6|分割点落在完整歌词句之后。逐段导出 WAV,并保留一份未切割的完整歌曲。
逐段导出时用统一命名:01_歌词首句.wav、02_歌词次句.wav、03_副歌第一句.wav。优先使用干净人声;伴奏太响、多人合唱或混响很重都会降低口型判断。切完后试听每个文件:开头不吞字,结尾不截尾音,段内只有一个主要演唱句。
第 5 步|在即梦“数字人”里逐段生成对口型视频
打开即梦,进入 Agent 模式,在模式下拉菜单选择“数字人”(不同版本也可能显示“配音生成数字人”)。每次只处理一个镜头:上传一张分镜图,再上传与它对应的 WAV;模式先选“快速模式”。
把下面动作描述粘贴到“动作描述”输入框:
女生在录音棚中深情演唱,闭眼,轻微点头,嘴部完整可见,前景麦克风虚化,镜头缓慢推近。
需要更有表演感时,再尝试:
女生在录音棚中深情演唱,闭眼,右手捂住胸口,最后再拿开,前景麦克风虚化,镜头缓慢环绕推进。

图 7|上传顺序:分镜图 → 对应短音频 → 动作描述 → 生成。一个分镜配一段音频,逐条完成。
第一次一定用简单版本。生成后按这个顺序检查:先看口型,再看脸,再看手,最后看镜头。如果不稳定,按固定顺序删词返工:先删“右手捂胸口”,再删“环绕”,最后只保留“深情演唱、轻微点头、缓慢推近”。减少动作通常比反复改模型更有效。
万象 / Wan2.5 备选做法
博主聊天中说明当时也用过 Wan2.5。它同样可以用“一张分镜图+对应音频+动作提示词”生成带口型的视频。操作逻辑不变:上传图片,上传短 WAV,粘贴同一动作描述,时长与音频对应后生成。当前万象版本和入口可能已更新,因此按钮名称以当前页面为准;如果即梦数字人入口不可用,再把万象作为替代,而不是同时混用两套模型,以免同一角色的质感跳变。
第 6 步|回到剪映合成,统一使用一条完整歌曲音轨
把所有生成的视频按歌词顺序放到同一时间线。将每个 AI 视频自带的分段音频静音,再重新导入那条未切割的完整歌曲,从第 0 秒铺到结尾。用歌词起音和波形峰值逐段对齐画面;镜头之间优先直接切,必须转场时控制在 0.1—0.2 秒。

图 8|上方是文字与效果轨,中间是连续的视频片段,下方重新铺一条完整歌曲,避免分段音频之间出现断裂。
导出前从头到尾检查三遍:第一遍只看口型,第二遍只看角色一致性,第三遍戴耳机检查爆音、重音和断点。建议导出 1080p、25 或 30 fps;帧率保持全片一致即可。
实测评估:哪里最容易失败,怎么修
口型像在念字,不像唱歌: 音频太长或伴奏太重。重新切成 4—8 秒,保留清晰单人声线。
嘴唇抖动或糊掉: 分镜角度太侧、麦克风遮嘴。换正面或 20—35 度侧脸,明确“嘴部完整可见”。
脸型在不同镜头变化: 分镜从零生成。所有镜头都必须从同一母图继续生成,并重复锁定发型、耳机、服装、光线。
手指变形、身体抽动: 动作指令过多。先删除手部动作,只保留轻微点头和推镜。
镜头之间像拼贴: 色温和光向不一致。分镜提示词都写“延续原图暖色逆光”,剪映里再统一曝光、色温和对比度。
成片接缝明显: 使用了每个片段自带的音频。片段音频全部静音,最终只保留一条完整歌曲。
最终验收线:连续观看 20—30 秒时,观众不会先注意到口型错位;角色的发型、耳机、服装和主光方向没有明显跳变;至少 80% 的镜头嘴部清楚;没有连续两次大幅手势。达到这四项,就说明流程已经被成功复刻。
来源与工具说明
原视频:抖音作者“AI训练师大宇”,《第 32 集:〈没出息〉喂饭教程来啦》,2025-10-26,查看原视频。
参数与功能核对参考:Midjourney Version、Midjourney Aspect Ratio、Midjourney Raw Mode、即梦数字人说明、万象图生视频说明。产品界面和额度会更新,以实际页面为准。
原片地址:https://www.douyin.com/video/7565251491657698611
作者主页:https://www.douyin.com/user/MS4wLjABAAAAq88f7-bGK0rGhXKUJuqHn1Gu6EfHJfv2mPrH5o39UD4