 物界前沿
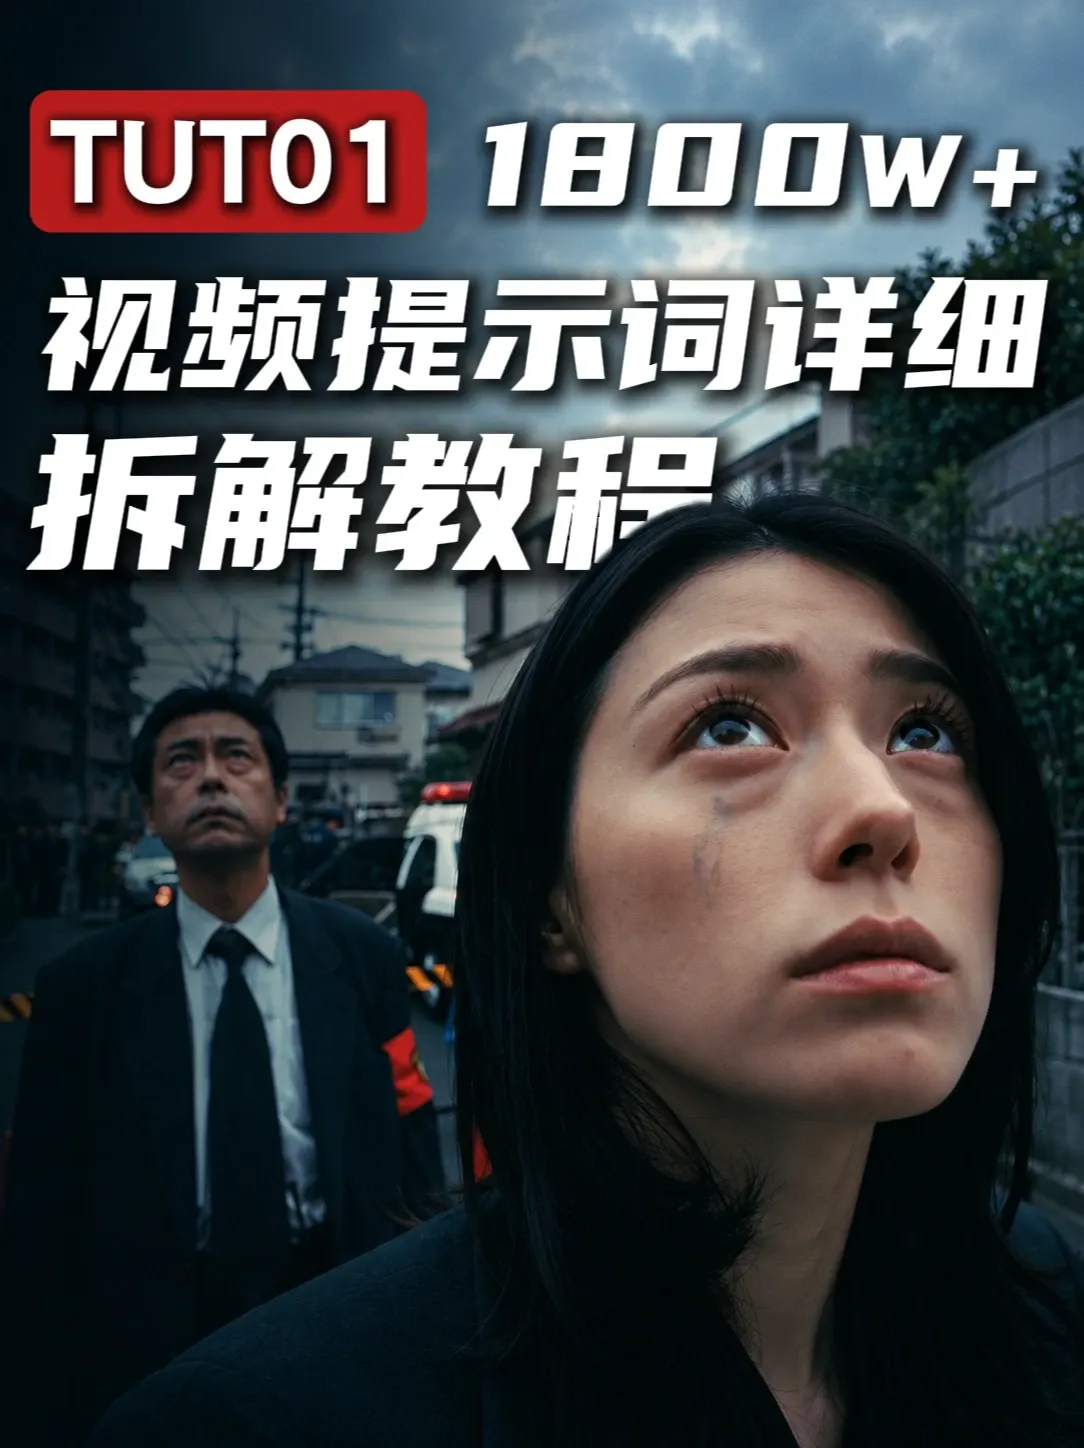
【1800w播放】都说提示词堪比论文的提示词拆解教程来了!
提示词堪比论文:AI 视频「提示词拆解」全流程
视频拆解与复刻教程
把一段参考视频,拆成一份能精确控制 AI 视频的「导演级」提示词:6183 字拆成九个模块,在 Flova.ai 里组织成可执行文档
来源:抖音视频「【1800w播放】都说提示词堪比论文的提示词拆解教程来了!」· 作者 @Surviving-黑猫阿 · 视频 3 分 13 秒 · 拆解核验日期 2026-09-27
来源与证据说明
原视频:抖音视频「【1800w播放】都说提示词堪比论文的提示词拆解教程来了!把自己个人…」,作者主页标题为「Surviving-黑猫阿的主页」(作品 10+;抖音号、粉丝数因平台反爬未能明确读取)。视频规格 1920×1080、29.99 fps、时长 3 分 13 秒(5798 帧)。本文由「视频拆解与复刻图文教程」流程产出:抽取原视频关键帧、逐帧还原方法链路,并核验所涉工具的官方资料;配图均为原视频整帧画面,未做裁切或遮挡。
原视频链接:douyin.com(视频作品编号 7687940864387140902)
证据与复刻声明:本文严格区分四层证据——来源画面事实(视频画面、字幕与界面可直接观察到的内容)、创作者披露(作者在视频中明确讲解的方法与工具)、官方资料(撰稿时在官方页面核验到的能力与说明)、复刻方案(为让读者做出同类作品而设计的步骤)。本文的复刻方案不等于创作者的完整原始流程;作者未在视频中披露的设置(如 AI 对话的完整系统提示词、色卡的生成方式等)一律标注为推断或我们的方案,不作虚构。文中出现的英文提示词、参数与模块名均按视频画面逐字整理。
一、结论:可以学、可以复刻,但它教的不是「模板」而是「方法」
一句话结论:这不是一条「给你一份提示词模板、复制就能用」的视频,而是一条「怎么把一段参考片拆解成结构化提示词」的方法论教程。作者先让 AI 把参考片段拆成七个维度,再把每个维度补成可执行的「制作锚点」,最后在 Flova.ai 的文档里组织成一份能直接驱动视频模型的提示词。
· 核心洞察(创作者披露,原话):「但并没有告诉视频模型该如何去制作」——一份只描述画面的提示词,AI 拿到也不知道该怎么拍。提示词的价值在于把「画面」翻译成「制作指令」。
· 方法骨架(来源画面事实):提示词 = 制作锚点,四个锚点是「主体、场景、镜头、光影」;再往下细分为摄影三要素(光圈、快门、ISO)、色彩逻辑、分镜时间轴、表演与声音设计。
· 最终形态(来源画面事实):一份 Markdown 文档《东京犯罪剧一镜到底提示词.md》(在 Flova.ai 的「文档」里编辑),里面包含摄影参数与镜头控制、画面整体视觉方向、真实皮肤、画面色彩与逻辑、光影、背景人物活动、主角的眨眼与表演、25 秒一镜到底分镜、声音设计等章节。
· 两个字数(来源画面事实):视频字幕先后出现「全文一共由 6183 个字组成」(随后拆成九个模块)与「Codex 反推出来的提示词全文共有 2000 字」。两处均为视频原字幕。
· 工具链(来源画面事实):参考片分析用 AI 对话(画面模型为 GPT-5.6 Sol);提示词整理与视频生成在 Flova.ai(视频模型为 Seedance 2.5);角色参考图用「MJ 制图」或 Banana;后期调色参考达芬奇(DaVinci Resolve)。

图 1:视频开场——播放量 1800w+,评论区满是「蹲一个完整教程」「求详细步骤」,说明这份提示词拆解方法的需求量极大。来源:原视频画面
二、这条视频在做什么:一条「从参考片到提示词」的流水线
来源画面事实:作者以日剧《铁证悬案 真实之门》中的一段约 24 秒连续长镜头为参考,把它一步步拆成一份完整提示词,再用它去生成同类画面。整条流程可以拆成六段:
环节 | 工具(画面显示) | 作用 |
① 选参考片 | 日剧《铁证悬案 真实之门》片段(约 24 秒) | 确定要复刻的目标:男女刑警抵达犯罪现场的一镜到底 |
② AI 拆解 | AI 对话(画面模型显示为 GPT-5.6 Sol) | 把参考片拆成整体判断、运镜、镜头语言、人物调度等维度 |
③ 反推提示词 | Codex(画面字幕「Codex 反推出来的提示词」) | 把拆解结果反向写成一版可用的视频提示词 |
④ 组织成文档 | Flova.ai「文档」(东京犯罪剧一镜到底提示词.md) | 把提示词按章节整理、补全摄影参数与制作细节 |
⑤ 出参考图 | MJ 制图(Midjourney)/ Banana(Nano Banana) | 生成角色参考图 / 角色卡,锁定人物形象 |
⑥ 生成视频 | Flova.ai × Seedance 2.5(字节视频模型) | 用整理好的提示词 + 参考图 + 色卡驱动视频生成 |
来源画面事实:视频中作者还特别鸣谢「Flova 提供的创作支持」,并展示了 Flova 的活动页(Flova × Seedance 2.5,活动期 9 月 21 日–10 月 20 日)。这条视频本质上是一次「方法论教学 + 平台演示」。
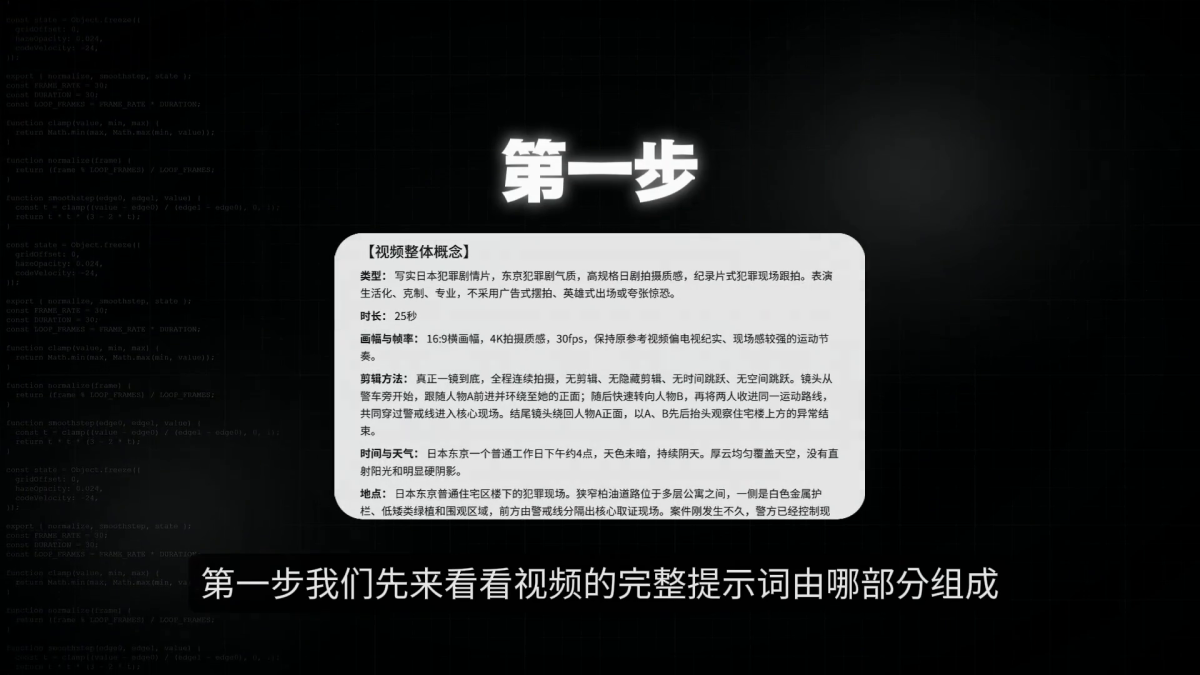
图 2:第一步——「我们先来看看视频的完整提示词由哪几部分组成」,右侧展示提示词第一模块【视频整体概念】(类型、时长、画幅与帧率、剪辑方法、时间与天气、地点)。来源:原视频画面

图 3:作者点出体量——全文一共由 6183 个字组成(随后拆分成若干模块)。来源:原视频画面
三、逐项拆解:从参考片到「导演级」提示词
3.1 拆解的第一层:提示词由九个模块组成
来源画面事实:作者先回答「完整提示词由哪几部分组成」,画面列出九个模块,分为左右两组:
· 左组:视频概念、摄影参数、人物皮肤、光影、分镜时间轴。
· 右组:人物参考、视觉方向、色彩逻辑、人物活动。
复刻要点(复刻方案):这九个模块可以理解成一份「视频提示词的骨架清单」——写提示词时逐个模块填空,就不容易漏。它不是唯一正确的分类,但确实覆盖了一条 AI 视频从「概念」到「可拍」的关键信息。

图 4:提示词拆解出的九个模块——视频概念、摄影参数、人物皮肤、光影、分镜时间轴 / 人物参考、视觉方向、色彩逻辑、人物活动。来源:原视频画面
3.2 参考片的拆解:七个框架 + 逐段运镜表
来源画面事实:作者对参考片《铁证悬案 真实之门》做的第一轮分析,用的是七个框架:整体判断、分镜时间轴、镜头语言、人物设计调度、场景空间、光线色彩及质感、情绪曲线。其中「整体判断」记录了时长 23.77 秒、画幅 16:9(1920×1080)、帧率 30fps、镜头形态(近距离广角连续跟拍)、剪辑判断(没有发现明确硬切,建议按「真实一镜到底」设计)与核心结构(女主先行、男主延迟登场,两人在警戒线前汇合,最后共同发现建筑上方的异常)。
来源画面事实:分析文档还包含一张「逐段运镜与动作」表,按 0–3.5 秒、3.5–6 秒、6–9.3 秒……逐段记录「画面与人物 / 摄影机运动 / 叙事作用」。另一节「镜头语言」总结出「摄影机运动都有栖息动机」:后跟用于带观众进入现场、绕到正面用于读取人物反应、用镜用于把叙事焦点从女性交给男性、警戒线遮挡用于强调进入禁区等。

图 5:参考片分析文档《铁证悬案 真实之门》——含「整体判断」(时长 23.77 秒、16:9、30fps、一镜到底判断)与「逐段运镜与动作」表。来源:原视频画面
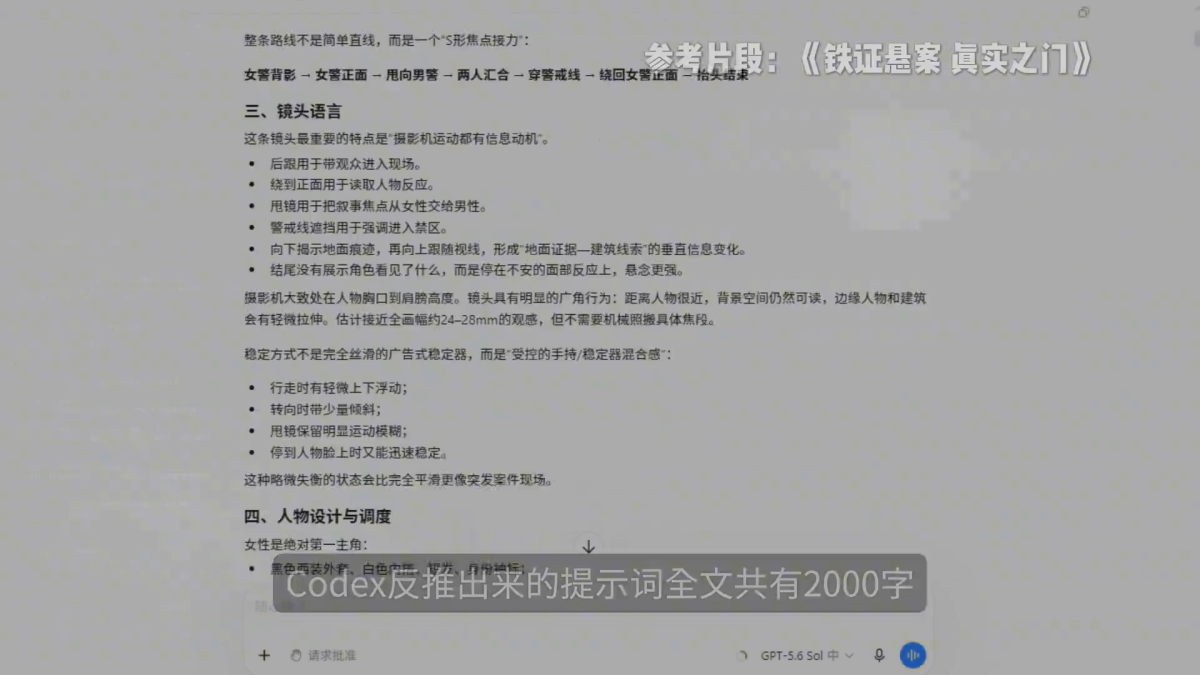
图 6:拆解继续深入「镜头语言」与「人物设计与调度」(女性是第一主角:黑色西装外套、白色内搭……);字幕显示「Codex 反推出来的提示词全文共有 2000 字」。来源:原视频画面

图 7:七个框架的完整清单——整体判断、分镜时间轴、镜头语言、人物设计调度、场景空间、光线色彩及质感、情绪曲线。来源:原视频画面
3.3 关键修正:从「描述画面」到「告诉模型怎么拍」
来源画面事实:作者把「修改前 / 修改后」两版分镜表并排对比。修改前的逐段表只写「画面与人物 + 摄影机运动」;修改后每一段都升级成三段式——「人物动作 / 镜头运动 / 背景」,例如 12–14 秒「A 与 B 汇合」:
修改后分镜写法示例(视频原文·12–14 秒)
人物动作:A 从画面左侧重新进入,位置比 B 更靠近镜头。B 加快一步追上,但保持在 A 右后方半个身位。
B 先看 A,再看警戒线内部;A 右手略微抬起,准备接触警戒线。
镜头运动:镜头 C 继续后退并移向道路中央,将两人收进同一构图。焦点先保持在 B,随后自然转向距离更近的 A。
背景:黄色警戒线变得清晰。两名蓝色防护服取证人员分别跪地拍照和整理证物箱,旁边放着关闭的证物箱。
创作者披露(原话/字幕):「但并没有告诉视频模型该如何去制作」「这些不是让你们对着提示词套模板」「而是足够精准」「写出来目的是什么」。作者的主张很清楚:分镜表如果只描述「画面上有什么」,AI 仍然不知道机位怎么走、焦点给谁、背景怎么动;必须把每个镜头写成可执行的制作指令。

图 8:「修改前 / 修改后」对比——分镜从「画面与人物 + 摄影机运动」升级为「人物动作 / 镜头运动 / 背景」三段式;字幕点出「但并没有告诉视频模型该如何去制作」。来源:原视频画面
3.4 提示词 = 制作锚点:主体、场景、镜头、光影
来源画面事实:作者用一张示意图概括方法论——「提示词 = 制作锚点」,四个锚点是主体、场景、镜头、光影,共同指向「主体」这一核心。字幕是「每一个锚点都是为了把画面转化成……」。
复刻要点(复刻方案):这四个锚点可以当作写提示词时的自查清单——每写完一段,回头检查它是否同时交代了「谁在演(主体)」「在哪演(场景)」「怎么拍(镜头)」「怎么打光(光影)」。缺哪一项,AI 就会在那一项上自由发挥。
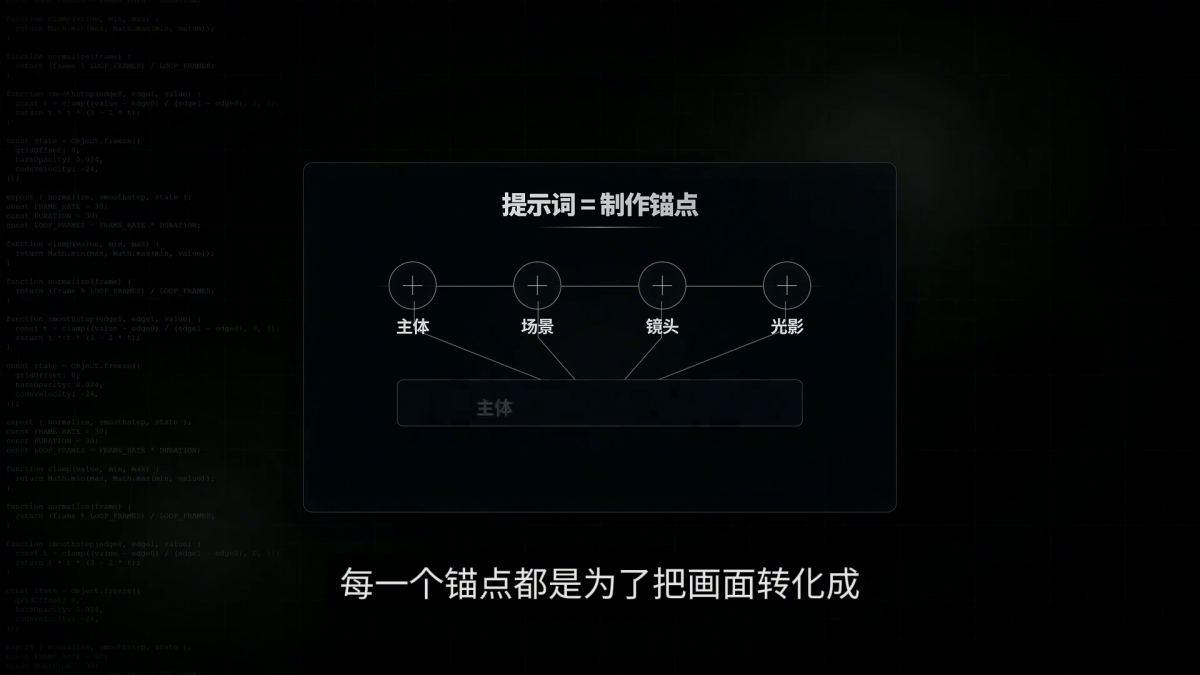
图 9:方法论核心——「提示词 = 制作锚点」,四个锚点:主体、场景、镜头、光影。来源:原视频画面
3.5 摄影参数与镜头控制:把「怎么拍」写死
来源画面事实:文档《东京犯罪剧一镜到底提示词.md》里「摄影参数与镜头控制」一节写得非常具体,原文要点如下:
摄影参数与镜头控制(视频原文摘录)
全程固定使用同一支全画幅等效 26mm 广角定焦镜头,不换镜头、不变焦、不使用数字推拉。
30fps 配合约 1/60 秒快门,保留行走、用镜和近景遮挡产生的自然运动模糊。
光圈以 T4 为主,保持人物与现场背景同时可读;进入建筑投下的较暗区域时,可以缓慢打开至 T3.2,
不能因人物遮挡而突然改变曝光。ISO 约 800,白平衡固定约 5600K,整体轻微欠曝,
保护阴天天空和白色警车高光,同时保留黑色西装的基本纹理。
将摄影机理解为一台在人类胸口至视线高度运动的低空虚拟无人机。高度主要维持在离地 1.4 至 1.6 米,
穿越警戒线时平缓下降至约 1.2 米。
摄影机通过连续的前进、后退、侧移、弧形环绕、偏航和小幅俯仰完成跟拍。所有转向都有启动、加速、
惯性滑行、减速和轻微回摆,不瞬移、不机械急停、不产生无重力漂浮。
主运动路径保持专业稳定,同时叠加真实手持摄影中的轻微脚步起伏、细小横滚、呼吸式位移和人工构图修正。
允许摄影机路微提前或滞后,允许人物和物体短暂遮挡,允许主体暂时偏离最佳构图后再被重新接住。
采用人工无线跟焦质感。焦点根据叙事在 A 的眼睛、B 的面部、触碰警戒线的手和地面证物之间转移。
人物突然靠近、转头或快速用镜时,允许焦点短暂偏软、轻微失焦并重新寻找主体。
远点转换保留轻微光学呼吸,不能无理由反复抽焦。
来源画面事实:同一文档还有「画面整体视觉方向」(写实日本犯罪剧现场质感、真实、克制、略带粗糙、固定广角镜头近距离观察人物、中等偏景深、人物清晰背景仍可辨认、保留轻微光学柔化、运动模糊和不完美)与「真实皮肤」(人物皮肤保留真实毛孔、额头纹、自然法令纹、轻微肤色不均和少量皮屑高光;B 保留真实胡须根部和年龄纹理)两节。
官方资料(核验日期 2026-09-27):这类「把摄影机当实体设备描述」的写法,是把影视摄影语言(焦距、光圈、快门、白平衡、跟焦方式、手持质感)翻译成模型能理解的自然语言——它不保证模型能 100% 还原物理参数,但能显著约束画面的运动质感与曝光倾向。
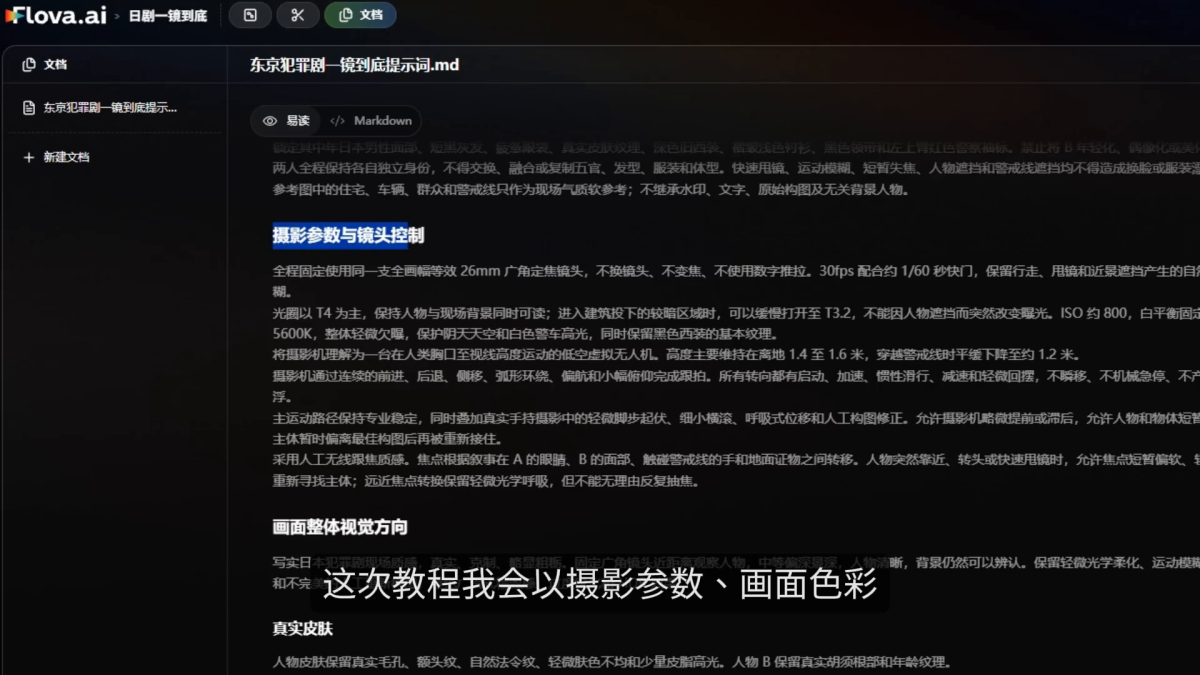
图 10:Flova.ai 文档《东京犯罪剧一镜到底提示词.md》——「摄影参数与镜头控制」一节(26mm 广角定焦、30fps、1/60 秒、T4→T3.2、ISO 800、白平衡 5600K)。来源:原视频画面

图 11:同一文档的「25 秒一镜到底分镜」——0–2 秒「从身份细节启动」、2–4 秒「由背影揭示建筑」、4–6 秒「从 A 身后环绕到正面」,每段含人物动作、镜头运动、背景。来源:原视频画面

图 12:作者强调「写清楚基本的摄影三要素」——光圈、快门、ISO(画面示意 F/2.8、1/125s、ISO)。来源:原视频画面
3.6 画面色彩与逻辑:把综合色调写成具体颜色
来源画面事实:文档「画面色彩与逻辑」一节原文写道:
画面色彩与逻辑(视频原文摘录)
整体以低饱和冷灰、灰绿、青灰和深炭黑为主,轻微欠曝。白色建筑和警车带冷灰色,人物肤色自然偏淡,
只比环境略暖。黑色西装压住画面重量,红色袖标、红色锥桶和黄黑警戒线作为少量高识别警示色。
全程保持统一综合色,不因镜头转向产生白平衡漂移,避免形成广告感;蓝色取证服保持中低饱和。
来源画面事实:为了在多段视频之间保持色调一致,作者还制作了一张「颜色色卡」,共八色,每个色块标注名字与十六进制值;字幕是「在每次生成视频时可以加入这张色卡当做画面色调参考」。下表按画面逐字整理(色块内小字较细,用途一栏已尽力辨识)。
色卡名 | 十六进制 | 画面标注的用途(视频原文,小字) |
云海象牙白 | #F7D6CB | 云海、时尚、女性主角向 |
琥珀蜜桃色 | #D8A07B | 天空、肤色稚嫩、慢火感 |
宫阙鎏金色 | #C47A3F | 水质动态、金属反光、警示感 |
朱砂战斗色 | #8F403D | 灯照、军潮、强调对抗的少量提示 |
青紫雾蓝色 | #80979D | 城墙、冷调、实用语感 |
苍松墨绿色 | #263A35 | 树林、荫蔽、中性单例环境 |
宫木深棕色 | #422A22 | 木质、包材、压迫感 |
玄青阴影色 | #202E36 | 阴影区、稳重、战争剧基调、冷色暗部 |
来源画面事实:作者随后切到达芬奇(DaVinci Resolve)的调色界面,字幕是「可以大大减少后期调色的工作量」——即用色卡在生成阶段就统一色调,减少后期逐镜校色的工作。
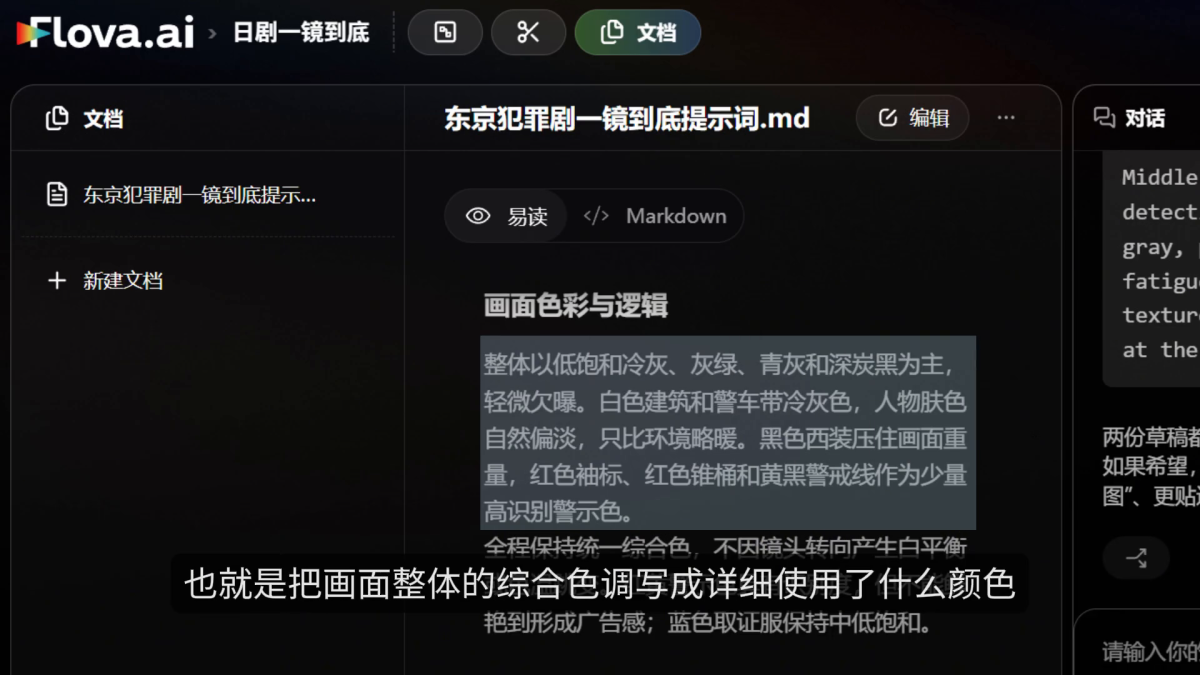
图 13:文档「画面色彩与逻辑」一节——把综合色调写成「低饱和冷灰、灰绿、青灰和深炭黑」,并点名红色袖标、红色锥桶、黄黑警戒线是少量警示色。来源:原视频画面

图 14:作者自制「颜色色卡」——八色,每块标注名称与十六进制值(如云海象牙白 #F7D6CB、玄青阴影色 #202E36),用于多段视频的色调参考。来源:原视频画面
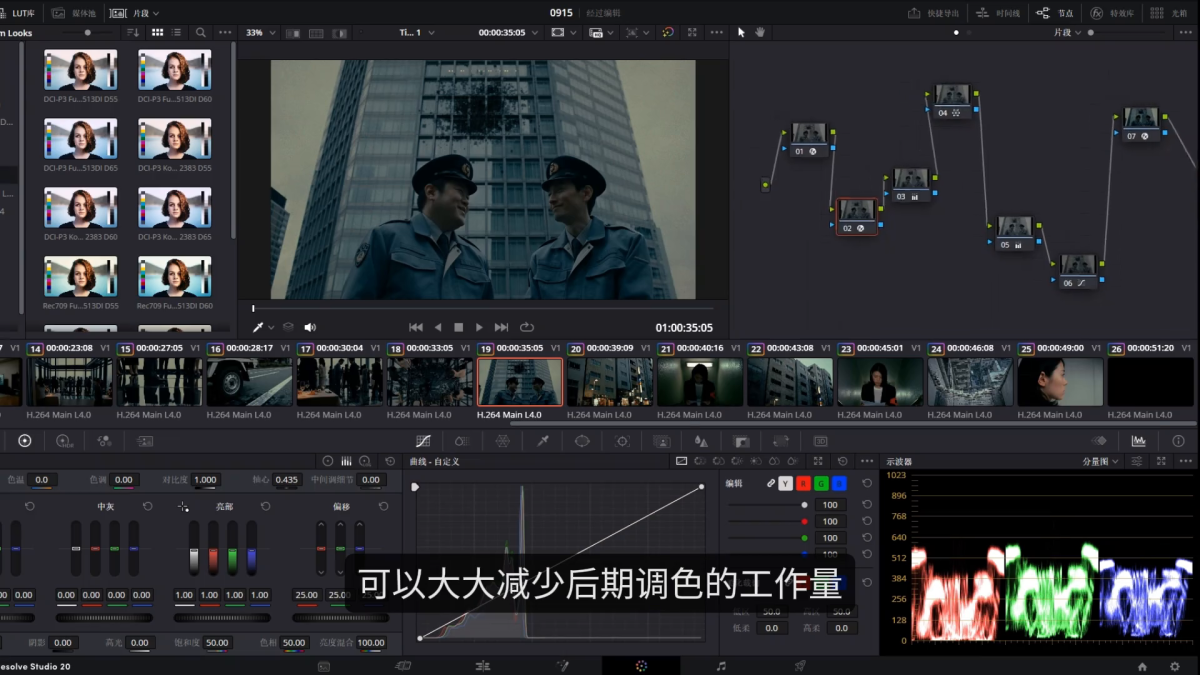
图 15:用色卡统一色调后,可在达芬奇(DaVinci Resolve)里减少后期调色工作量。来源:原视频画面
3.7 光影:决定整个场地的光源布置
来源画面事实:文档「光影」一节原文写道:
光影(视频原文摘录)
阴天天空是唯一主光源,形成大面积柔和漫射光,没有直射阳光、硬阴影或人工轮廓光。
白色警车和住宅外墙为人物提供微弱冷白反射。A、B 面部朝向开阔天空的一侧略亮,额头、鼻梁和上颧骨
获得柔和亮面;眉骨下、眼窝、鼻翼、下颌和颈部保留自然阴影。人物转头时,明暗随面部角度平缓变化,
光源方向不能跟随人物移动。阳台下方、楼道入口、车辆背面和人群内部自然偏暗。
警车漆面、玻璃和警戒线只有柔和高光。禁止灯光闪烁、人物面部忽明忽暗和无来源补光。
来源画面事实:视频中间还穿插了一段教学素材,用人体模型演示「直射光 vs 慢反射」「暖色调 vs 冷色调」的差别,并展示了「没有层次、没通透感」的反例画面。字幕是「决定整个拍摄场地的光源布置」。
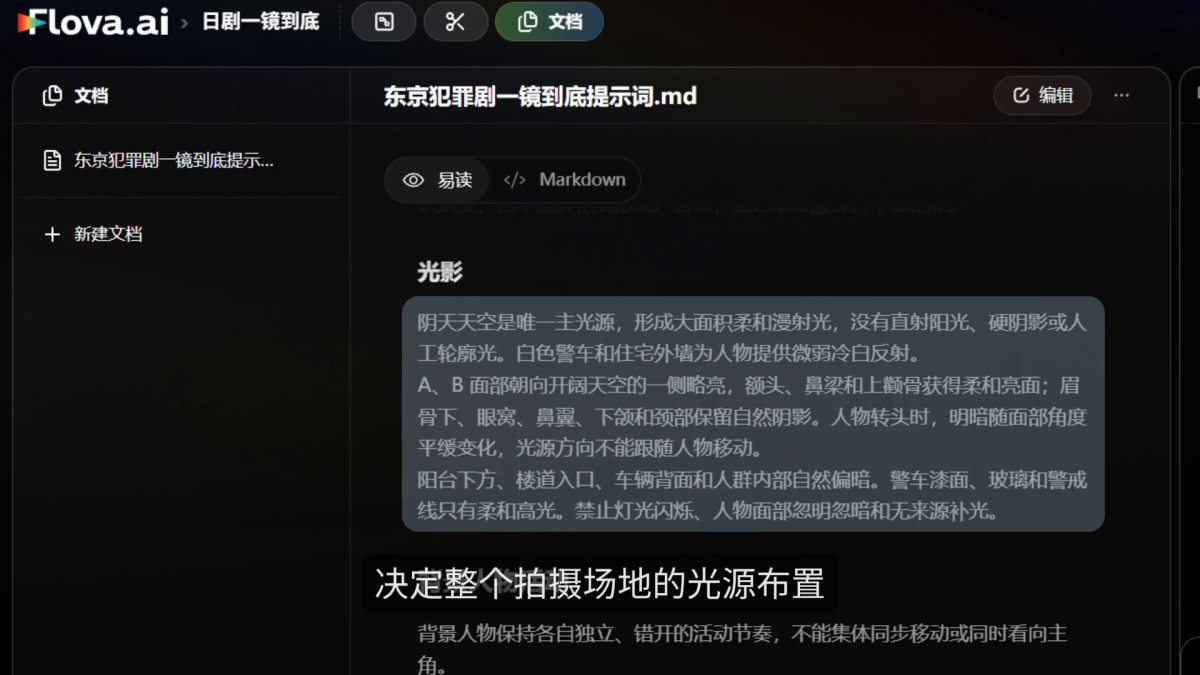
图 16:文档「光影」一节——「阴天天空是唯一主光源」,并明确禁止「灯光闪烁、人物面部忽明忽暗和无来源补光」。来源:原视频画面
3.8 分镜控制与 25 秒一镜到底分镜
来源画面事实:视频里出现一个「分镜控制」面板,把每个镜头拆成「画面内容 → 如何拍」两组参数,可调「景别(中景)/ 机位(平视 -30°)/ 运动(缓推)/ 缩放(1.0)」,并显示「已锁定」。字幕是「而是要准确的控制」。
来源画面事实:文档正文则是一份完整的「25 秒一镜到底分镜」,按两秒一段(末尾 1 秒)写成,每段含人物动作、镜头运动、背景三项。段落主题如下:
时间 | 段落主题 | 该段要做的事(视频原文要点) |
0–2 秒 | 从身份细节启动 | 袖标先进入画面;镜头从 A 右后侧贴近跟瞄,焦点由袖标转向肩背,产生轻微镜头呼吸 |
2–4 秒 | 由背影揭示建筑 | A 继续前行、步速略减;镜头随 A 上身缓慢上仰,让建筑立面逐渐展开 |
4–6 秒 | 从 A 身后环绕到正面 | 镜头向 A 左侧弧形位移,绕到左前方,反向偏航把 A 保持在画面中 |
6–8 秒 | 正面倒退跟随 A | 镜头在 A 前方约 1.2 米处向后退,沿道路轻微右移,为 A 的视线留出空间 |
8–10 秒 | 快速转向 B | A 的视线转向画面右后方;镜头加速右偏航并短距离横移,焦点转向 B |
10–12 秒 | B 离开警车 | B 松开车门转向犯罪现场;镜头后退、保持距离并向左侧移动,为 A 重新入画预留空间 |
12–14 秒 | A 与 B 汇合 | B 加快一步保持在 A 右后方半个身位;镜头移向道路中央把两人收进同一构图 |
14–16 秒 | 逼近警戒线 | A 先低头判断高度再伸出手;镜头减速、高度由 1.5 米降至 1.4 米,焦点在眼睛与手之间转移 |
16–18 秒 | 共同穿越警戒线 | A 抬警戒线、B 托住并低头跟随;镜头与 A 同步下降至约 1.2 米,从空隙中穿过 |
18–20 秒 | 揭示核心现场 | A 恢复正常步速看向地面标记;镜头绕向右后方,焦点从 A 侧脸转到地面物证 |
20–22 秒 | 从证物回到 A | A 放慢到几乎停止;镜头沿弧线绕到右前方并升高至约 1.6 米,把 A 与物证收进同一视线 |
22–24 秒 | 后脑发异常 | A 仰头看向住宅楼上方;镜头缓慢上仰,让建筑外沿进入画面上方 |
24–25 秒 | 悬念停留 | A 维持抬头凝视、呼吸短暂变浅;镜头停止主动运动,只保留轻微呼吸感 |
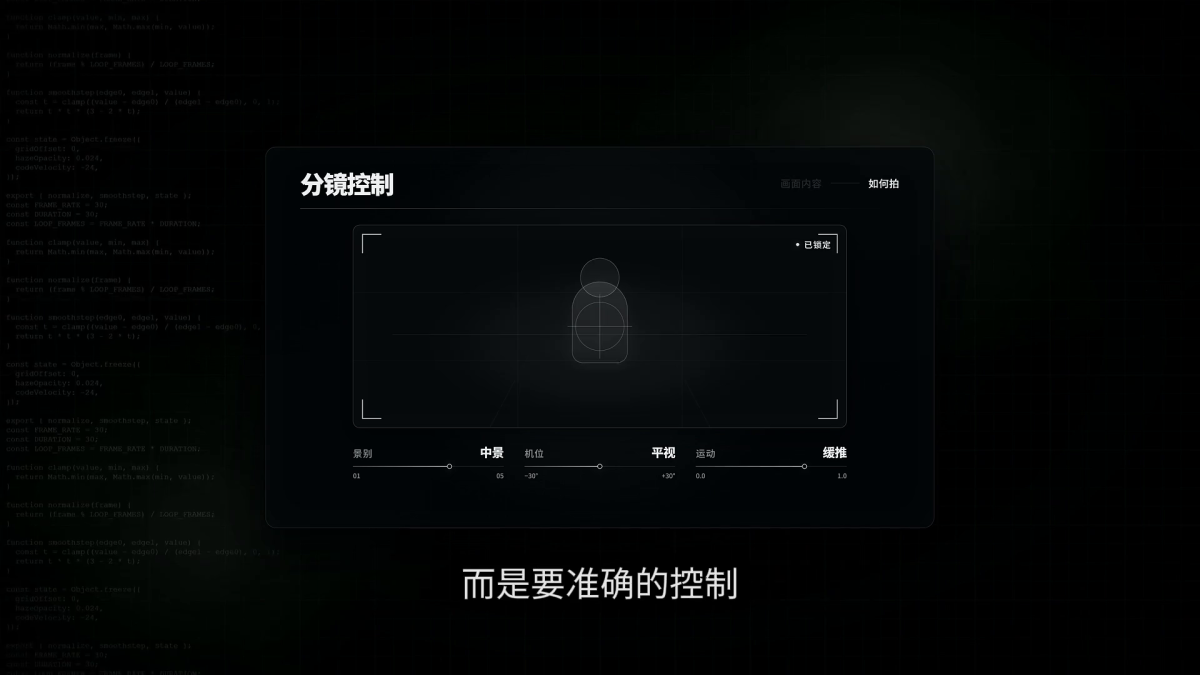
图 17:「分镜控制」面板——把每个镜头拆成「画面内容 → 如何拍」,可调景别、机位、运动、缩放,并显示「已锁定」。来源:原视频画面
3.9 表演与背景人物:把「演员怎么演」写进去
来源画面事实:文档有两节专门写表演。「背景人物活动」要求背景人物保持各自独立、错开的行动节奏,不能集体同步移动或同时看向主角;并分别规定制服警察、取证人员、记者的分工动作,要求「所有背景人物忽略镜头,不得抢夺 A、B 的视觉中心,也不得复制 A、B 的面孔和服装」。
来源画面事实:「主角的眨眼与表演」一节把生理细节量化为可执行指令——A 在 25 秒内自然眨眼约 3 至 5 次、B 约 2 至 4 次,间隔不均匀、两人不能同步眨眼;眨眼主要发生在转头、重新聚焦、风吹眼睛或结束一次观察之后,快速行走和发现关键线索时减少眨眼;并禁止固定频率、连续快速眨眼、左右眼不同步或长时间完全不眨眼。此外还规定了身体动作的自然顺序:发现目标时眼睛先移动、头部随后转向、肩膀与上身最后跟随;改变方向时脚步和重心先调整……
复刻要点(复刻方案):把「眨眼次数」「动作先后顺序」这种量化和时序写成指令,是这份提示词最反直觉、也最有效的地方——它直接针对 AI 视频常见的「抽搐式眨眼」「动作同步化」「表情瞬变」等毛病。字幕「演员要怎么演」点出了这一节的目的。
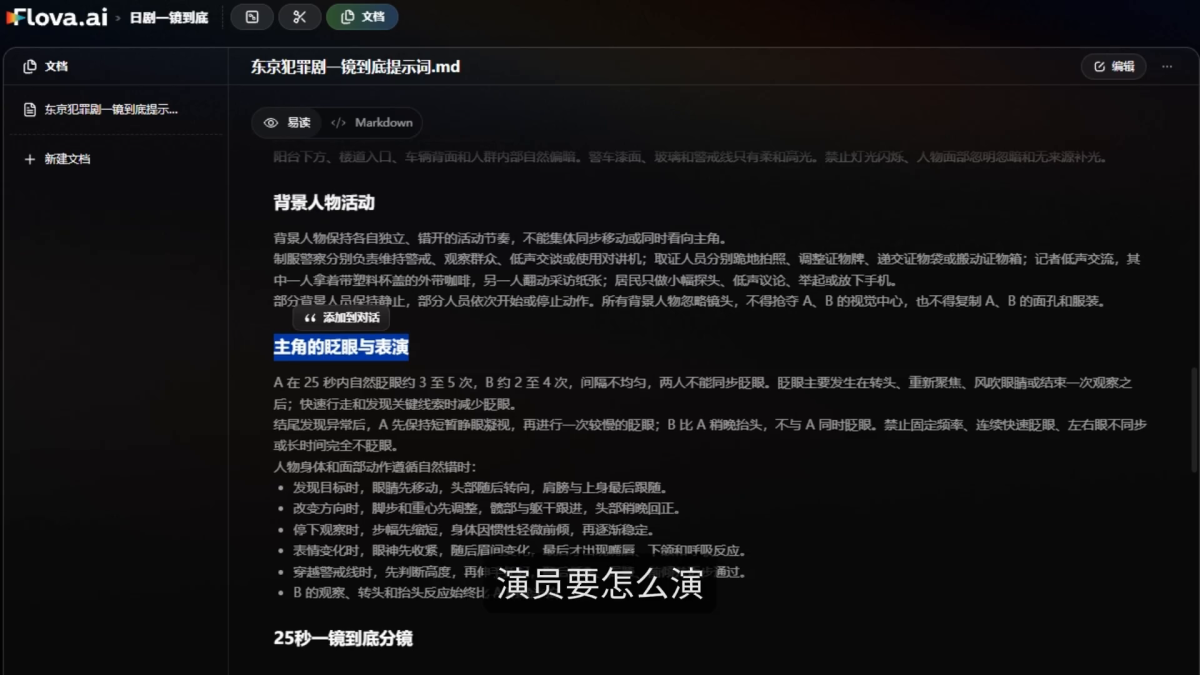
图 18:文档规定「背景人物活动」与「主角的眨眼与表演」——含眨眼次数、间隔、身体动作的先后顺序等量化指令;字幕「演员要怎么演」。来源:原视频画面
3.10 参考图与角色卡:锁定人物形象
来源画面事实:文档右侧的「对话」面板里,作者让 AI 为「人物 A(女性刑警)」和「人物 B(中年男性刑警)」分别写了一段英文的「character reference portrait」提示词。人物 B 的原文如下:
人物 B 角色参考图提示词(视频原文,英文)
Realistic character reference portrait for a Japanese crime drama series. Middle-aged Japanese male
police detective, short black hair with visible gray, pronounced eye bags conveying fatigue and
experience. Authentic skin texture with age: visible beard stubble at the roots, skin creases,
wrinkles, and natural uneven tone. Wearing a slightly worn dark suit, a wrinkled light-colored
dress shirt, black necktie, red police armband on the left upper arm. Expression is focused,
weary but professional - not youthful, not idealized, not model-like.
Skin texture is critically important: real pore detail, age lines, fatigue under-eye shadows.
Absolutely no skin smoothing, beauty retouching, or plastic AI-generated skin. No over-sharpening,
no HDR.
Overall color palette: low-saturation, cool gray, gray-green, and blue-gray tones. Overcast
diffused ambient light, no harsh directional shadows, no artificial rim or portrait lighting.
Background: clean neutral backdrop or subtly suggested Tokyo residential street environment -
kept minimal to avoid distracting from the subject.
来源画面事实:这两段提示词的下方工具条显示「MJ 制图」(Midjourney),字幕是「我们来讲解参考图的生成」;作者随后展示四视图角色卡(正面 / 侧面 / 背面等),字幕是「就可以使用角色卡」,并提到「或者用 Banana 制作这种角色卡」。
来源画面事实:作者对比了「长视频精准控制」与「单次生成」两种做法——角色卡适合长视频、多镜头的精准控制;而单次生成时可以直接用概念图,因为「概念图里包含背景信息」。字幕点题:「真正决定 AI 视频上限的」。

图 19:文档「对话」面板里的人物 B 英文参考图提示词(强调真实皮肤质感、禁止磨皮),工具条显示「MJ 制图」(Midjourney)。来源:原视频画面
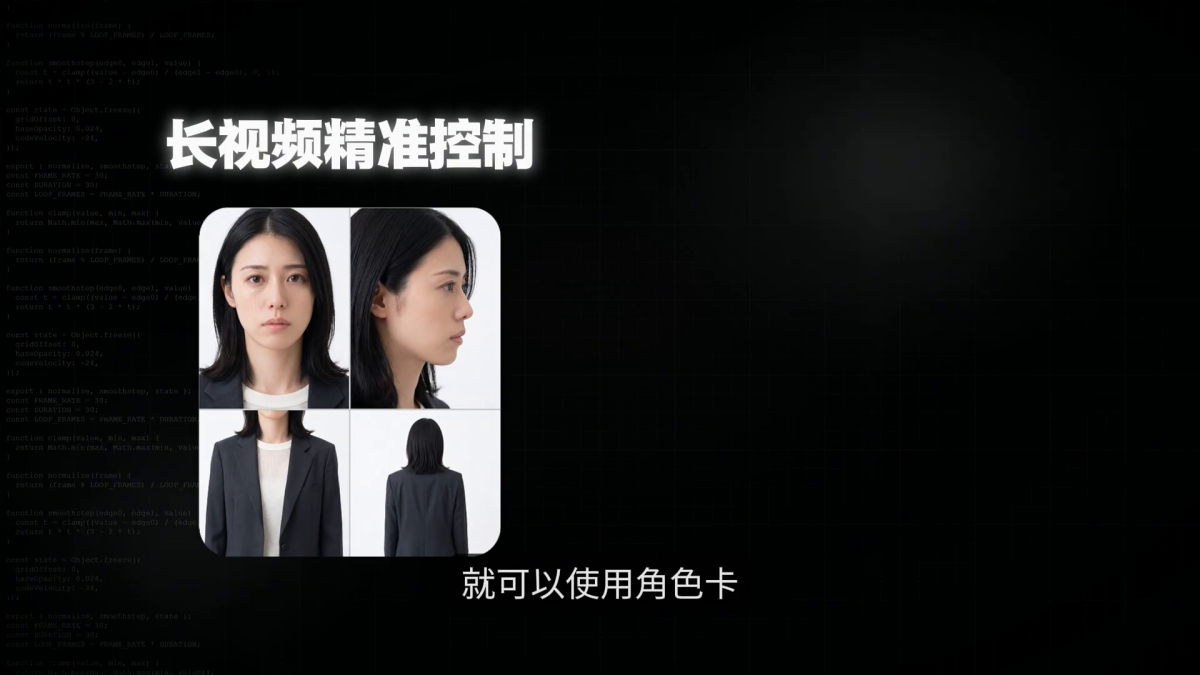
图 20:四视图「角色卡」(正面 / 侧面 / 背面等)用于「长视频精准控制」;作者也提到可用 Banana 制作。来源:原视频画面
3.11 声音设计:BGM 之外,还有「现场声」
来源画面事实:文档「声音设计」一节原文写道:全程无传统 BGM、无配乐旋律,只保留真实、连续的东京住宅区案发现场声;声音远近与左右方向随摄影机移动自然变化,不能平均铺满。并细分为「环境底声(叶子被微风吹动的细小摩擦声、远处城市交通形成的低沉雾声)」「人群声音(警戒线外的低声交谈、现代相机快门声和手机快门声)」「人物近声(A、B 行走时的衣料摩擦和不同节奏的鞋底声;两人呼吸轻微可闻,紧张时变浅但不夸张)」。
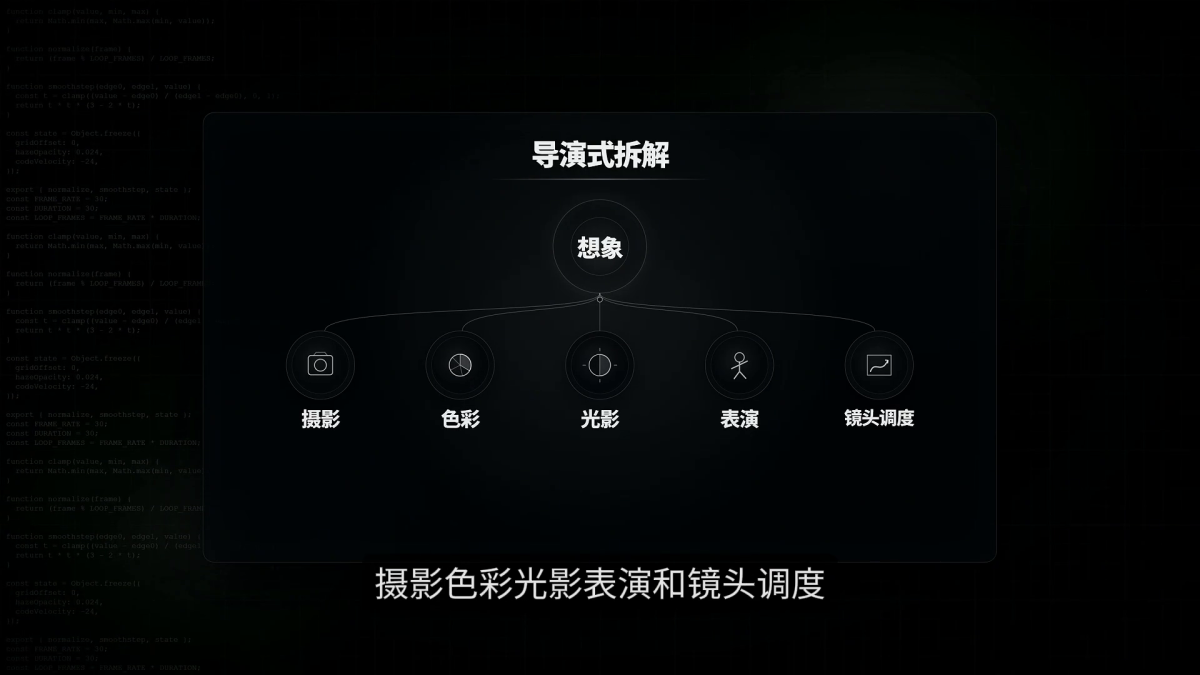
图 21:「导演式拆解」——想象之下是摄影、色彩、光影、表演和镜头调度五项能力。来源:原视频画面

图 22:文档「声音设计」一节——全程无 BGM,只保留连续的案发现场声(环境底声、人群声音、人物近声)。来源:原视频画面
3.12 方法论收尾:从「模仿画面」走向「表达想法」
创作者披露(原话/字幕):作者把整条方法论的落点总结为「导演式拆解」——核心不是你会不会套模板,而是「你能不能像导演一样思考」「掌握这些底层能力」,最终实现「从模仿画面走向表达想法」的「创作的跃迁」。视频结尾的正文则再次出现 Flova × Seedance 2.5 的活动页。

图 23:作者的方法论落点——「创作的跃迁:从模仿画面走向表达想法」。来源:原视频画面

图 24:视频结尾展示 Flova × Seedance 2.5 活动(9 月 21 日–10 月 20 日):720P 约 0.31 元/秒、480P 约 0.156 元/秒等档位。来源:原视频画面
四、工具与参数速查表
项目 | 内容(来源画面事实 + 官方资料) |
方法论核心 | 提示词 = 制作锚点(主体、场景、镜头、光影);分镜要写成「人物动作 / 镜头运动 / 背景」三段式 |
提示词骨架 | 九个模块:视频概念、摄影参数、人物皮肤、光影、分镜时间轴、人物参考、视觉方向、色彩逻辑、人物活动 |
参考片分析框架 | 七个框架:整体判断、分镜时间轴、镜头语言、人物设计调度、场景空间、光线色彩及质感、情绪曲线 |
两个字数(视频字幕) | 拆解全文 6183 字;Codex 反推出来的提示词全文 2000 字 |
摄影三要素 | 光圈(画面示意 T4→T3.2)、快门(约 1/60 秒)、ISO(约 800);另加 26mm 广角定焦、30fps、白平衡约 5600K |
镜头运动原则 | 把摄影机当「低空虚拟无人机」(离地 1.4–1.6 米,穿越警戒线降至约 1.2 米);转向有启动、加速、惯性滑行、减速、轻微回摆 |
跟焦设定 | 人工无线跟焦质感;焦点在 A 的眼睛、B 的面部、触碰警戒线的手、地面证物之间转移;允许短暂偏软、轻微失焦 |
色彩逻辑 | 低饱和冷灰 / 灰绿 / 青灰 / 深炭黑;轻微欠曝;红色袖标、红色锥桶、黄黑警戒线为少量警示色 |
颜色色卡 | 八色(云海象牙白 #F7D6CB、琥珀蜜桃色 #D8A07B、宫阙鎏金色 #C47A3F、朱砂战斗色 #8F403D、青紫雾蓝色 #80979D、苍松墨绿色 #263A35、宫木深棕色 #422A22、玄青阴影色 #202E36) |
光影 | 阴天天空为唯一主光源,大面积柔和漫射光;禁止灯光闪烁、面部忽明忽暗、无来源补光 |
分镜控制面板 | 景别(中景)/ 机位(平视 -30°)/ 运动(缓推)/ 缩放(1.0),可「已锁定」 |
角色参考图 | 英文 character reference portrait 提示词;输出四视图角色卡(正面 / 侧面 / 背面),工具为 MJ 制图或 Banana |
声音设计 | 无 BGM、无配乐旋律;只保留现场声(环境底声、人群声音、人物近声),声场随摄影机移动变化 |
主平台 | Flova.ai(flova.ai)——文档 + 对话 + 视频模型;视频模型为 Seedance 2.5(字节 Seed 团队,2026-07-31 发布) |
分析 / 出图模型 | AI 对话(画面模型为 GPT-5.6 Sol,OpenAI);参考图用 MJ(Midjourney)/ Banana(Nano Banana) |
五、提示词与参数清单(可对照复刻)
说明:「视频原文」按视频画面逐字整理;「复刻模板」是为通用化而由本文编写,不冒充创作者原文。发送前请把【】里的内容替换成你自己的题材。
① 让 AI 拆解参考片的提问模板(复刻方案,基于视频做法)
这是一段参考视频。请把它拆解成以下七个框架,逐项分析:
整体判断 / 分镜时间轴 / 镜头语言 / 人物设计调度 / 场景空间 / 光线色彩及质感 / 情绪曲线。
其中分镜时间轴请按时间分段,每段写清「人物动作 / 镜头运动 / 背景」三项,
不要只描述画面里有什么,要写清楚「怎么拍」。
② 摄影参数与镜头控制(视频原文摘录)
全画幅等效 26mm 广角定焦,不换镜头、不变焦、不使用数字推拉;30fps + 约 1/60 秒快门;
光圈 T4 为主(暗区可缓开至 T3.2);ISO 约 800;白平衡约 5600K;整体轻微欠曝;
摄影机 = 低空虚拟无人机(离地 1.4–1.6 米,穿越警戒线降至约 1.2 米);
人工无线跟焦质感,焦点在眼睛、面部、手、地面物证之间转移。
③ 色彩与光影(视频原文摘录)
整体低饱和冷灰、灰绿、青灰、深炭黑,轻微欠曝;红色点缀作少量高识别警示色;
阴天天空为唯一主光源,大面积柔和漫射光,无直射阳光、硬阴影或人工轮廓光;
禁止灯光闪烁、人物面部忽明忽暗和无来源补光。
④ 表演指令(视频原文摘录)
A 在 25 秒内自然眨眼约 3–5 次,B 约 2–4 次,间隔不均匀,两人不能同步眨眼;
眨眼主要发生在转头、重新聚焦、风吹眼睛或结束一次观察之后;
发现目标时眼睛先移动,头部随后转向,肩膀与上身最后跟随;
禁止固定频率、连续快速眨眼、左右眼不同步或长时间完全不眨眼。
⑤ 声音设计(视频原文摘录)
全程无传统 BGM、无配乐旋律;只保留真实、连续的现场声;
声音远近与左右方向随摄影机移动自然变化,不能平均铺满;
分三层:环境底声、人群声音、人物近声(衣料摩擦、鞋底声、呼吸)。
⑥ 角色参考图提示词结构(视频原文为英文,此处示意结构)
Realistic character reference portrait for ... [题材] ...
外貌与年龄特征 + 服装配饰 + 表情气质(聚焦、克制、非理想化)
Skin texture is critically important: real pore detail ... no skin smoothing, no beauty retouching.
Overall color palette: low-saturation, cool gray ... ; Overcast diffused ambient light.
Background: clean neutral backdrop ... kept minimal to avoid distracting from the subject.
六、手把手复刻 11 步
第 1 步 选一段你喜欢的参考片(越接近你要拍的目标越好,例如一段一镜到底的连续镜头),截取 20–30 秒。
第 2 步 把参考片交给 AI 对话(视频用的是显示为 GPT-5.6 Sol 的模型),按七个框架要求它逐项拆解:整体判断、分镜时间轴、镜头语言、人物设计调度、场景空间、光线色彩及质感、情绪曲线。
第 3 步 拿到拆解后,重点检查「分镜时间轴」——如果它只写了画面里有什么,就追问:请把每一段改写成「人物动作 / 镜头运动 / 背景」三段式,并说明要怎么做。
第 4 步 让 AI(视频里用的是 Codex)把拆解结果反推成一版可直接使用的视频提示词。
第 5 步 在 Flova.ai 新建一份文档(视频里是 Markdown 文档《…一镜到底提示词.md》),把提示词按九个模块归档:视频概念、摄影参数、人物皮肤、光影、分镜时间轴、人物参考、视觉方向、色彩逻辑、人物活动。
第 6 步 补「摄影参数与镜头控制」:焦距、帧率、快门、光圈、ISO、白平衡,以及摄影机的运动方式与跟焦方式。
第 7 步 补「画面色彩与逻辑」「光影」:写清主光源、色温倾向、点缀色,并做一张颜色色卡(名字 + 十六进制)。
第 8 步 补「分镜」:把 25 秒(或你的目标时长)按 2 秒一段拆开,每段写人物动作 / 镜头运动 / 背景;如有分镜控制面板,同时设定景别、机位、运动、缩放。
第 9 步 补「表演与背景人物」:把眨眼频率、动作先后顺序、背景人物的独立节奏都写成指令。
第 10 步 补「声音设计」:决定是否有 BGM,以及现场声分几层、声场如何随镜头变化。
第 11 步 出参考图 / 角色卡:用 MJ 制图或 Banana 生成角色四视图,锁定人物形象;然后用 Flova × Seedance 2.5 把提示词 + 参考图 + 色卡一起喂进去生成视频。
七、可复刻度评测与已知限制
可复刻度评测(依据视频画面与官方资料,核验日期 2026-09-27):
环节 | 成本 / 门槛 | 可复刻度 | 说明 |
AI 拆解参考片 | 有可用的 AI 对话账号 | 高 | 方法可完全照做;拆解质量取决于提问与模型能力 |
反推提示词 | 同上(视频用 Codex) | 高 | 本质是把分析写成结构化文本,可复现 |
组织成文档 | Flova.ai 账号(新用户有免费额度) | 高 | Markdown 文档任意工具都能写 |
颜色色卡 / 角色卡 | MJ(Midjourney)/ Banana 出图成本 | 中高 | 工具都可选,关键是「四视图 + 统一色调」 |
生成视频 | Flova × Seedance 2.5 按秒计费 | 中 | 结果依赖抽卡与人工筛选;长镜头一致性仍是难点 |
长视频一致性 | 需角色卡 + 参考素材 + 局部精修 | 中 | 视频已展示「角色卡 + 局部修改」缓解方案 |
说明:上表「可复刻度」为本文基于视频画面与官方资料给出的判断,非实测结论;「成本」仅按视频画面出现的信息与官方公开信息列示,请以各平台当日实际价格为准。
已知限制:
限制 | 说明 |
作者信息不完整 | 抖音号与粉丝数因平台反爬未能明确读取;昵称取自其抖音主页标题「Surviving-黑猫阿的主页」,标注为页面推断。 |
不是「套模板」即得 | 作者明确说「不是让你们对着提示词套模板」。文中所有提示词都需要按你的题材重写,直接套用他人的画面描述不会得到同样结果。 |
AI 拆解的完整性无法保证 | 视频里 AI 对参考片的拆解(6183 字)是否完整、是否有人工润色,作者未逐项展示;本文只能复刻「拆解—反推—组织—补细节」这个流程。 |
色卡小字辨识度有限 | 颜色色卡中每块下方的小字用途说明较细,本文已尽力辨识并标注;颜色名称与十六进制值可信度较高。 |
成本与活动价会变 | 视频展示的 Flova × Seedance 2.5 活动价(9 月 21 日–10 月 20 日)为限时活动;价格、额度与模型入口均可能调整,请以官方当日页面为准。 |
模型参数不等于物理还原 | 26mm、T4、ISO 800 等写法是「约束画面倾向」的语言,模型不一定逐项物理还原;它改善的是运动质感与曝光一致性,而非精确复现摄影机参数。 |
平台与版权边界 | 用他人影视片段做参考分析属学习用途;生成物若商用,需自行确认平台条款与素材版权,本文不构成法律意见。 |
八、交付前检查清单
· 参考片已选定并截取到位(建议 20–30 秒、尽量是一段连续镜头)。
· 已用七个框架完成拆解,且「分镜时间轴」是「人物动作 / 镜头运动 / 背景」三段式,不是单纯描述画面。
· 九个模块已逐项填空,没有明显空缺(视频概念、摄影参数、人物皮肤、光影、分镜时间轴、人物参考、视觉方向、色彩逻辑、人物活动)。
· 摄影参数已写清:焦距、帧率、快门、光圈、ISO、白平衡,以及摄影机运动方式与跟焦方式。
· 色彩逻辑与光影已写明主光源、色温倾向、点缀色,并准备了颜色色卡。
· 分镜已按时间分段,且设定了景别、机位、运动、缩放等可量化参数。
· 表演指令含眨眼频率、动作先后顺序;背景人物有独立节奏、不抢焦点。
· 声音设计已确定是否用 BGM,并写明现场声的分层与声场变化。
· 角色参考图 / 角色卡已生成(四视图),人物形象与色调统一。
· 已用完整的提示词 + 参考图 + 色卡驱动视频模型,并评估抽卡成本与筛选工作量。
· 已核对所用平台当前价格、活动与模型入口,确认在可接受范围内。
九、来源与参考链接
原视频(抖音):抖音「提示词堪比论文的提示词拆解教程」(@Surviving-黑猫阿)
Flova.ai(主平台):www.flova.ai
Seedance 2.5(Flova 介绍页):flova.ai/video-models/seedance-2-5
GPT-5.6(OpenAI 官方):openai.com/index/gpt-5-6
Midjourney:www.midjourney.com
DaVinci Resolve:blackmagicdesign.com
即梦(Seedance 个人入口):jimeng.jianying.com
官方链接核验日期:2026-09-27。模型版本、活动价格、免费额度与功能入口会随时间变化,以官方当日页面为准。文中引用的参考片《铁证悬案 真实之门》版权归其权利人所有,本文引用仅为说明拆解方法之用。
免责声明:本教程基于创作者公开发布的视频画面与公开页面整理,仅用于学习与复刻参考;文中提到的第三方工具与影视素材版权归各自所有,使用前请阅读其官方条款。本文与视频创作者、工具方均无隶属关系。配图取自原视频整帧画面,未做裁切或遮挡,其中出现的界面、文字与素材版权归原视频作者及原软件方所有。
发布于 2026-09-22
原片地址:https://www.douyin.com/video/7687940864387140902
关于作者:Surviving-黑猫阿(抖音号 39098885329)